
De 66 a 28 minutos de CI sin quitar ni un test
De 66 a 28 minutos de CI sin quitar ni un test
Cada vez que alguien de mi equipo subía un commit, la integración continua facturaba unos 66 minutos de máquina. No tardaba 66 minutos: tardaba unos 13 de reloj, pero repartidos en más de una docena de trabajos en paralelo, y lo que se paga es la suma.
Esta semana lo dejé en 28. La cobertura es la misma y no se ha quitado ninguna comprobación.
Este artículo cuenta dónde se iba el tiempo, qué cambié y las 2 propuestas de mi agente de IA que tumbé por el camino.
El problema: nadie había mirado la factura por trabajo
El pipeline funcionaba y estaba en verde casi siempre. Por eso mismo nadie lo miraba.
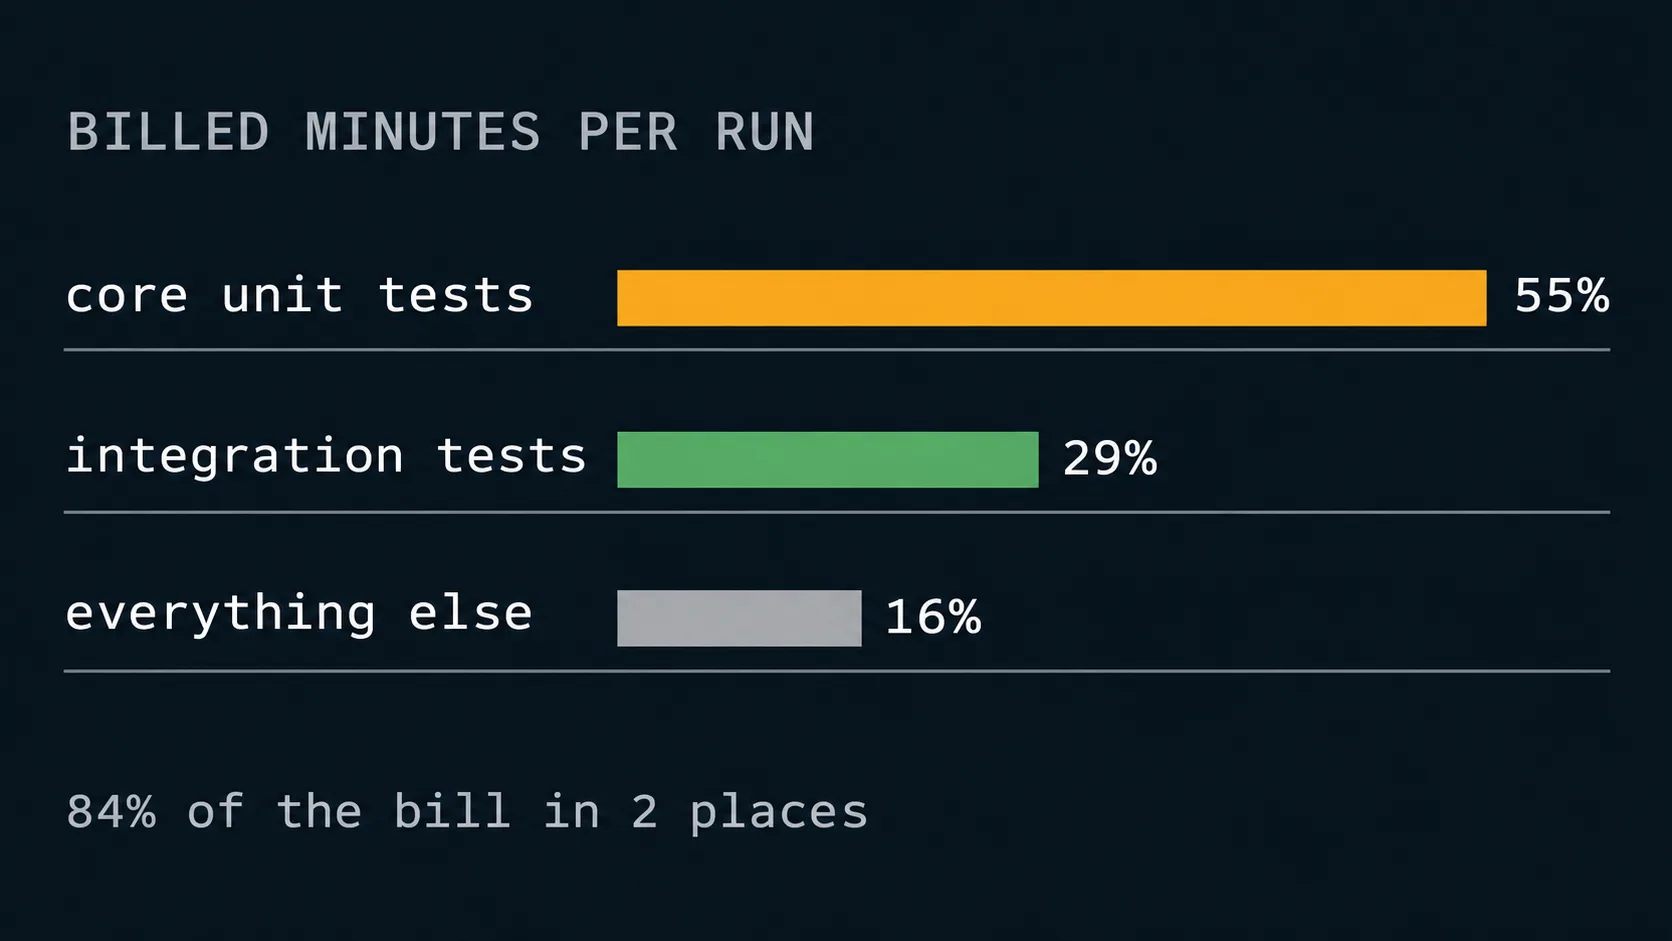
Lo primero fue lo más aburrido: sumar los minutos de cada trabajo de una ejecución normal, uno por uno. Lo hice con un agente de IA leyendo las ejecuciones reales. Salió esto:
- El 55 % de la factura eran los tests unitarios del núcleo.
- El 29 % eran los tests de integración.
- El resto, todo lo demás junto.
Con esa tabla ya no hacía falta opinar. Había 2 sitios donde mirar y el resto no merecía la pena.
Qué encontramos
Los tests unitarios comprobaban tipos en cada fichero. La configuración de jest del núcleo hacía que ts-jest validara los tipos de TypeScript de cada spec antes de ejecutarlo. Es trabajo útil, pero repetido en cada una de las casi 600 suites. Lo medí en 8 specs sin caché: 10,8 segundos con la comprobación, 3,6 sin ella.
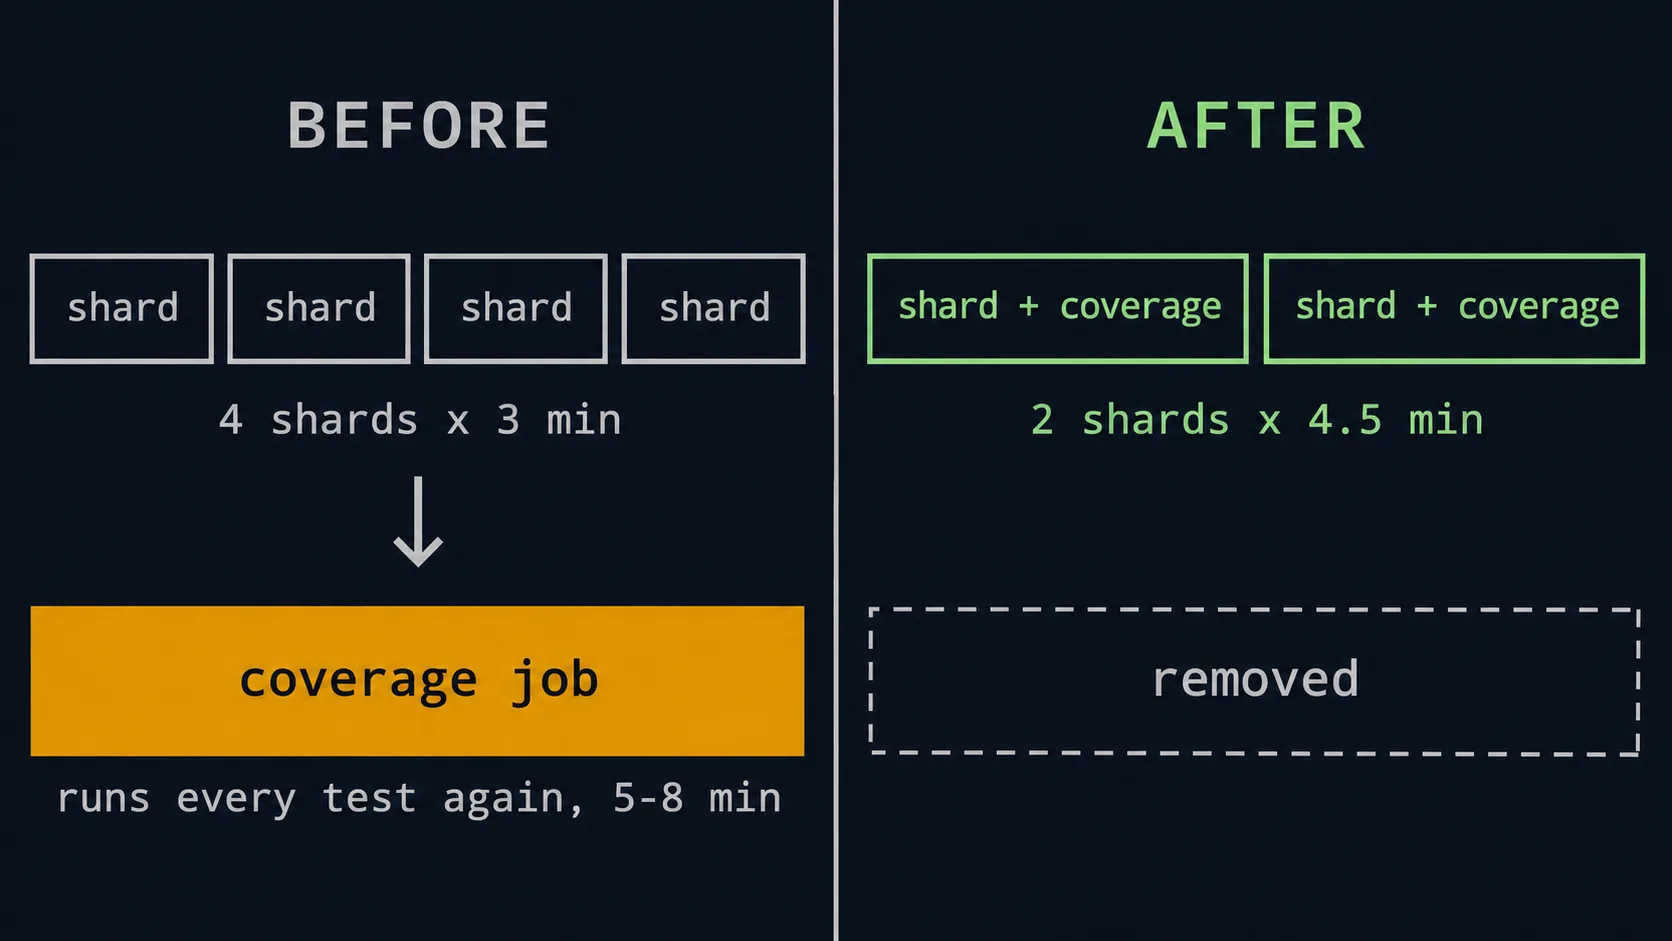
Los tests de integración se ejecutaban 2 veces. Había 4 fragmentos que los corrían, y después un trabajo aparte que volvía a lanzar todos los tests solo para medir la cobertura. Entre 5 y 8 minutos repitiendo lo que ya se había hecho.
Un commit nuevo no cancelaba la ejecución del anterior. Si subías 3 commits seguidos a una PR, pagabas 3 ejecuciones completas y solo te importaba la última.
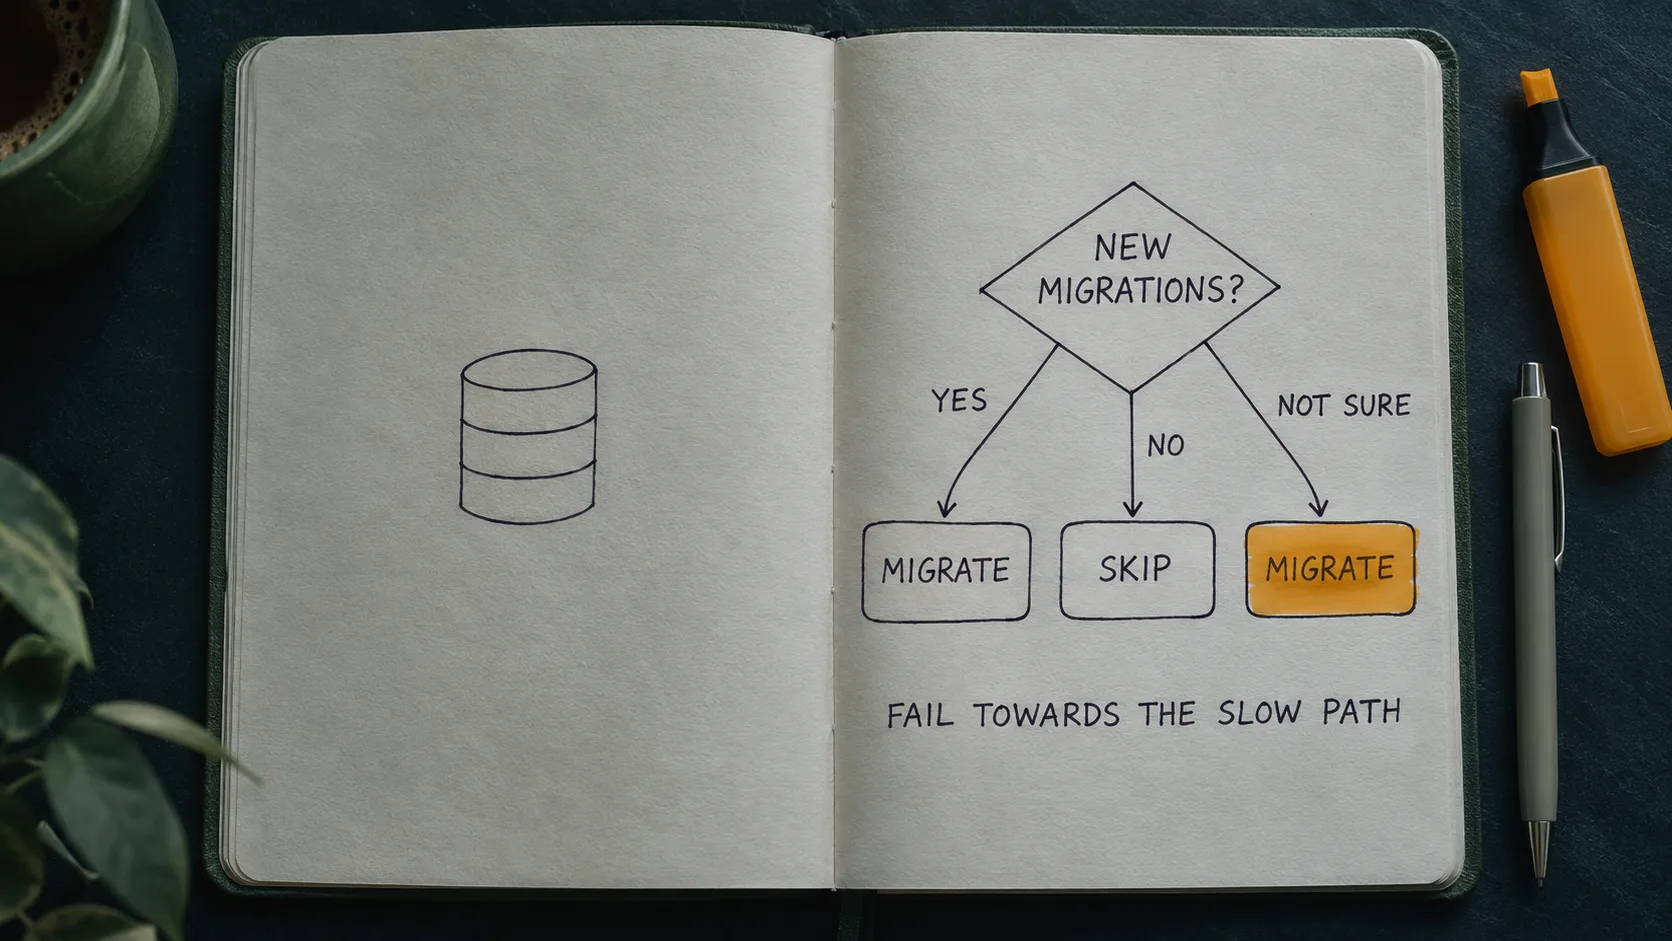
El despliegue se conectaba a la base de datos aunque no hubiera nada que migrar. Instalaba dependencias, se autenticaba en la nube, abría un túnel y conectaba, para descubrir que no había migraciones nuevas.
Lo que hicimos
- Los tests solo transpilan. Activé
isolatedModulesen la configuración del núcleo. Los tipos se siguen comprobando, pero en un trabajo nuevo que pasa el compilador una sola vez: 1,2 minutos. Cada fragmento de unitarios bajó de 5-10 minutos a 1,5-2. - La integración corre una vez. Los fragmentos recogen su propia cobertura, pasan de 4 a 2, y el trabajo que lo repetía todo desaparece.
- Una ejecución nueva cancela la anterior en las PR. En las ramas principales no se cancela nunca.
- La caché de transformación de
jestse guarda entre ejecuciones, así que solo se recompila lo que ha cambiado. - La migración se salta cuando no hay nada nuevo. Un script corto compara los ficheros de migración con el commit del último despliegue correcto. Si no ha cambiado ninguno, no instala, no se autentica y no abre el túnel.
Las 2 propuestas que tumbé
El análisis lo hizo el agente y venía con un plan. 2 partes de ese plan no pasaron.
La primera era de forma. Proponía repartir el trabajo en 4 PR pequeñas, una por cambio, que es lo que dice el manual. Preferí una sola. Lo que limita no es el tamaño de una PR, es cuántas se pueden revisar bien.
La segunda era de fondo. En su lista había una línea que decía que las credenciales de la nube en los trabajos de test probablemente sobraban. Proponía quitarlas.
No sobraban. El pipeline se conecta a través de ellas para ejecutar las migraciones.
Lo que salió de ahí es el punto 5: no quitar la conexión, sino no usarla cuando no hace falta. Y con una condición. El script falla hacia el lado seguro: si no encuentra un despliegue anterior, si el commit de referencia no está en la historia o si git da cualquier error, ejecuta la migración igual que antes. Solo se la salta cuando está seguro de que no hay nada.
El resultado, medido
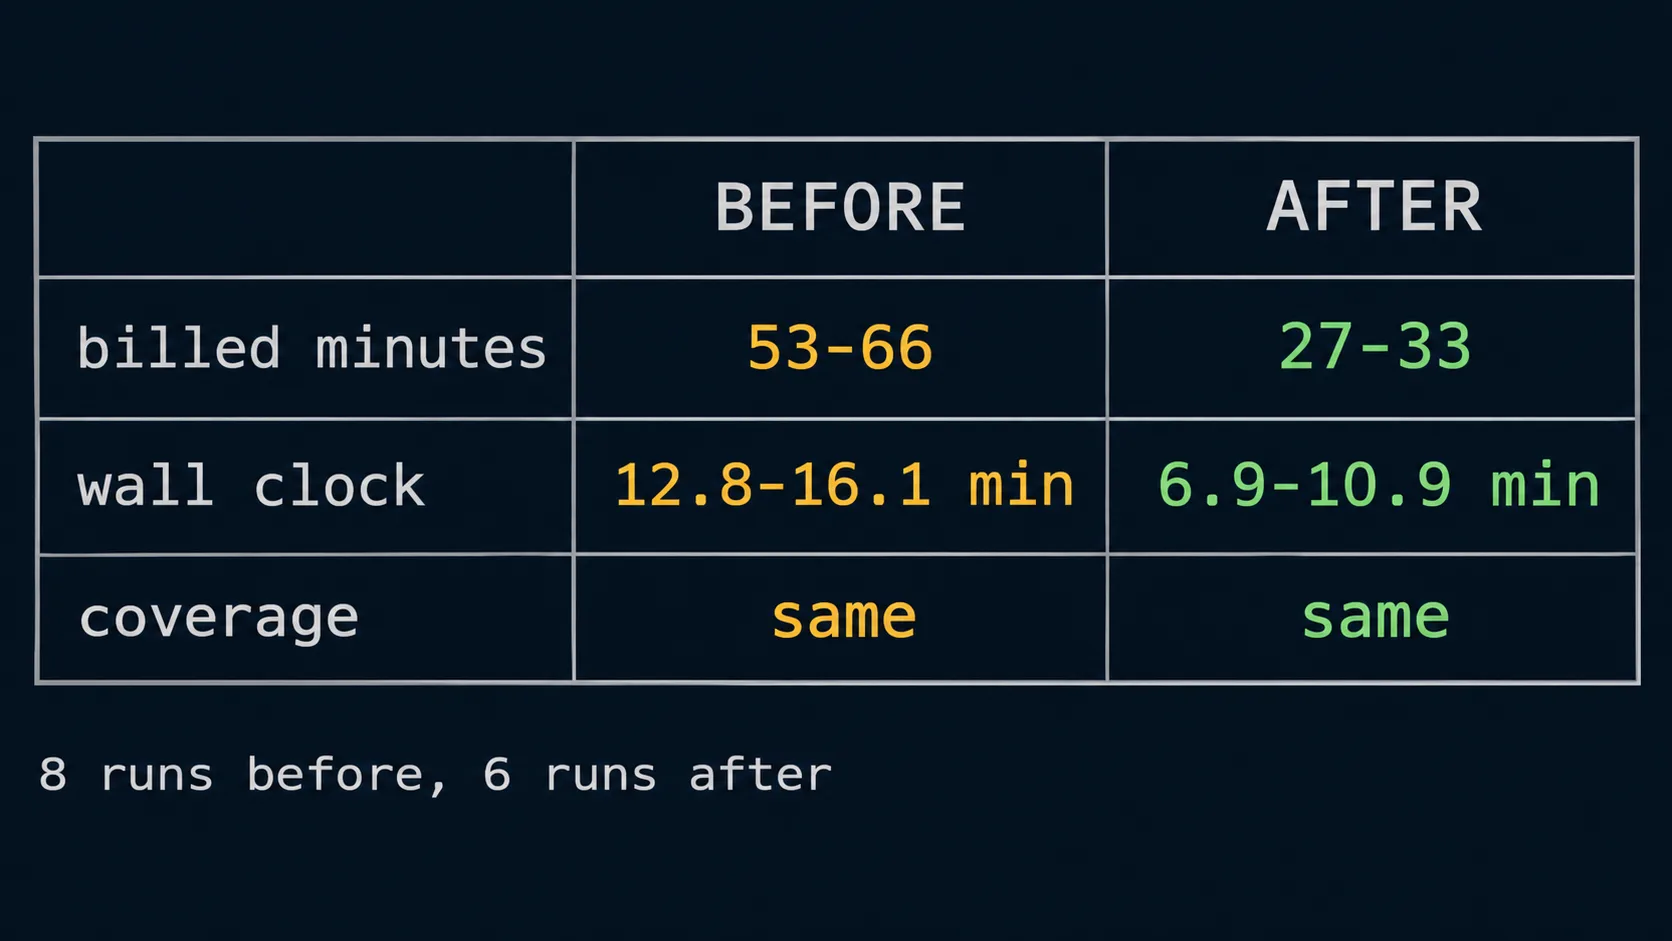
Los tiempos salen de las ejecuciones reales del repositorio. Los minutos de máquina se han calculado sumando la duración de cada trabajo redondeada al minuto; no son una lectura de la factura del proveedor. Comparé las 8 últimas antes del cambio con las 6 primeras después:
| Antes | Después | |
|---|---|---|
| Minutos facturados por ejecución | 53-66 | 27-33 |
| Tiempo de reloj | 12,8-16,1 min | 6,9-10,9 min |
| Cobertura de líneas | la misma | la misma |
| Tests unitarios, por fragmento | 5-10 min | 1,5-2 min |
La suite completa del núcleo, casi 600 suites y más de 5.000 tests, pasa entera con la configuración nueva.
Queda una cosa que no pude probar antes de fusionar: el salto de la migración solo se ejercita con un despliegue de verdad. Lo dije en la PR tal cual.
Lo que me llevo
3 reglas, y ninguna es de jest.
Mide por trabajo antes de optimizar. El 84 % de la factura estaba en 2 sitios, y la caché, que es lo que se suele tocar primero, era lo de menos.
Antes de borrar una credencial o una conexión, busca quién la usa. Incluido el flujo de despliegue, que no es el que tienes abierto. Y si alguien la usa, la pregunta es otra: ¿se puede hacer condicional?
Un atajo en un pipeline tiene que fallar hacia lo lento. Si el script que decide saltarse un paso se equivoca, que se equivoque ejecutándolo.
Un pipeline en verde no avisa de que está caro. Hay que ir a mirarlo.