
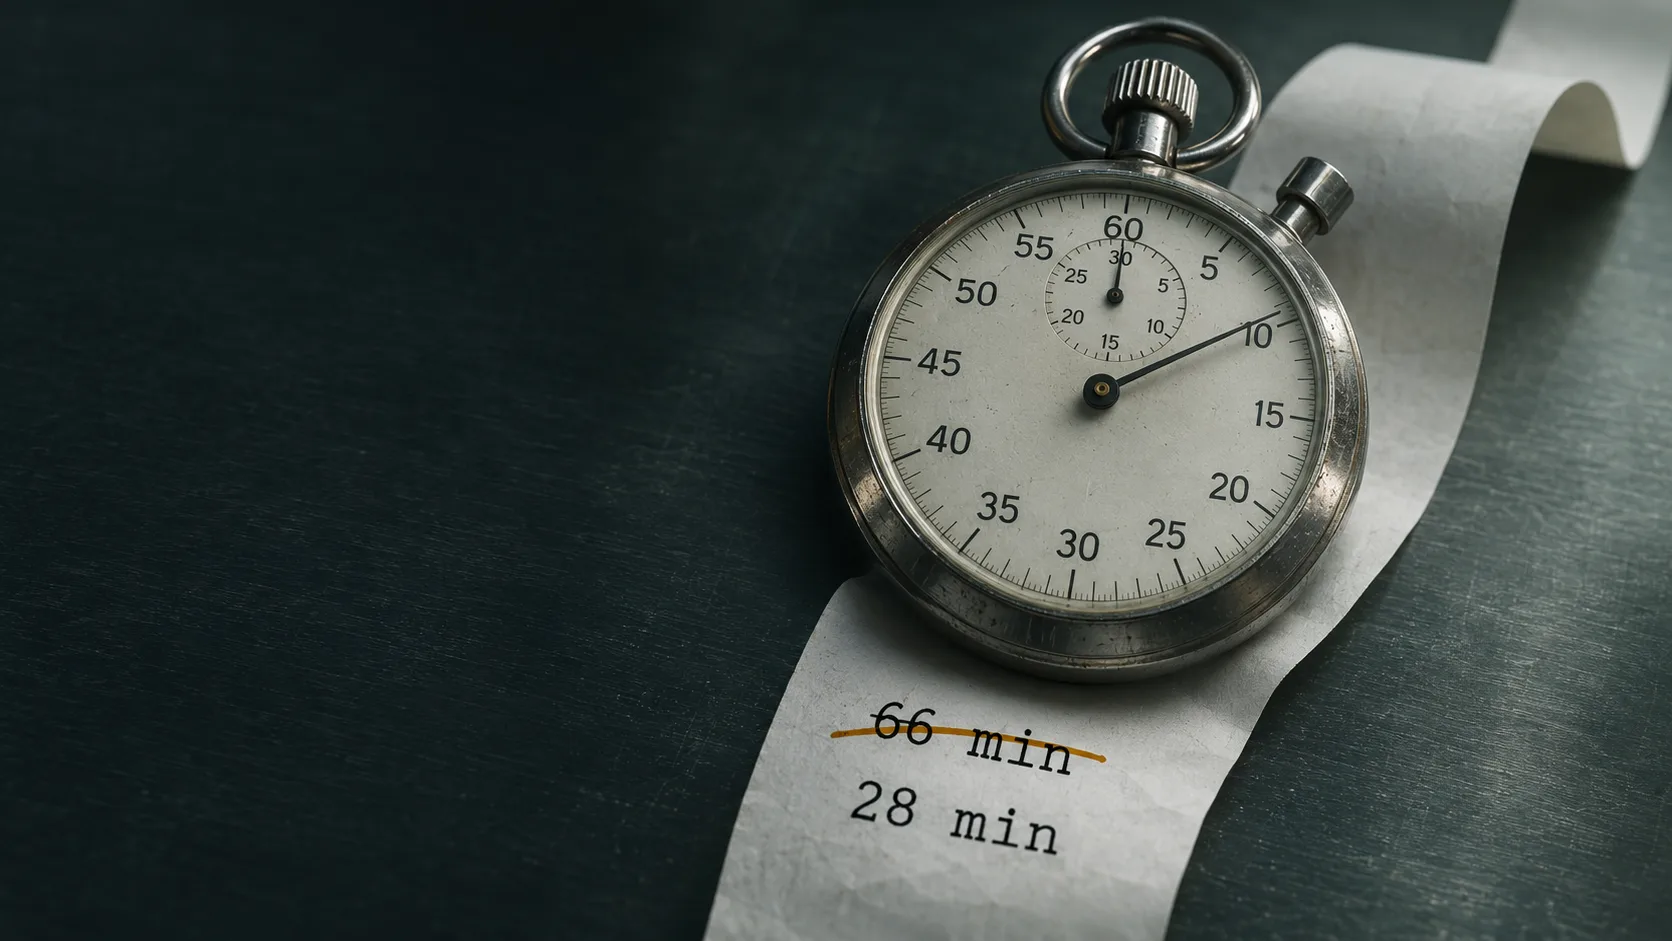
De 66 a 28 minutos de CI sin quitar ni un test
Un pipeline facturaba 66 minutos de máquina por commit. Lo dejé en 28 con la misma cobertura: dónde se iba el tiempo y qué propuestas de un agente rechacé.
Lo que vamos construyendo: proyectos, decisiones técnicas y aprendizajes.
Un pipeline facturaba 66 minutos de máquina por commit. Lo dejé en 28 con la misma cobertura: dónde se iba el tiempo y qué propuestas de un agente rechacé.
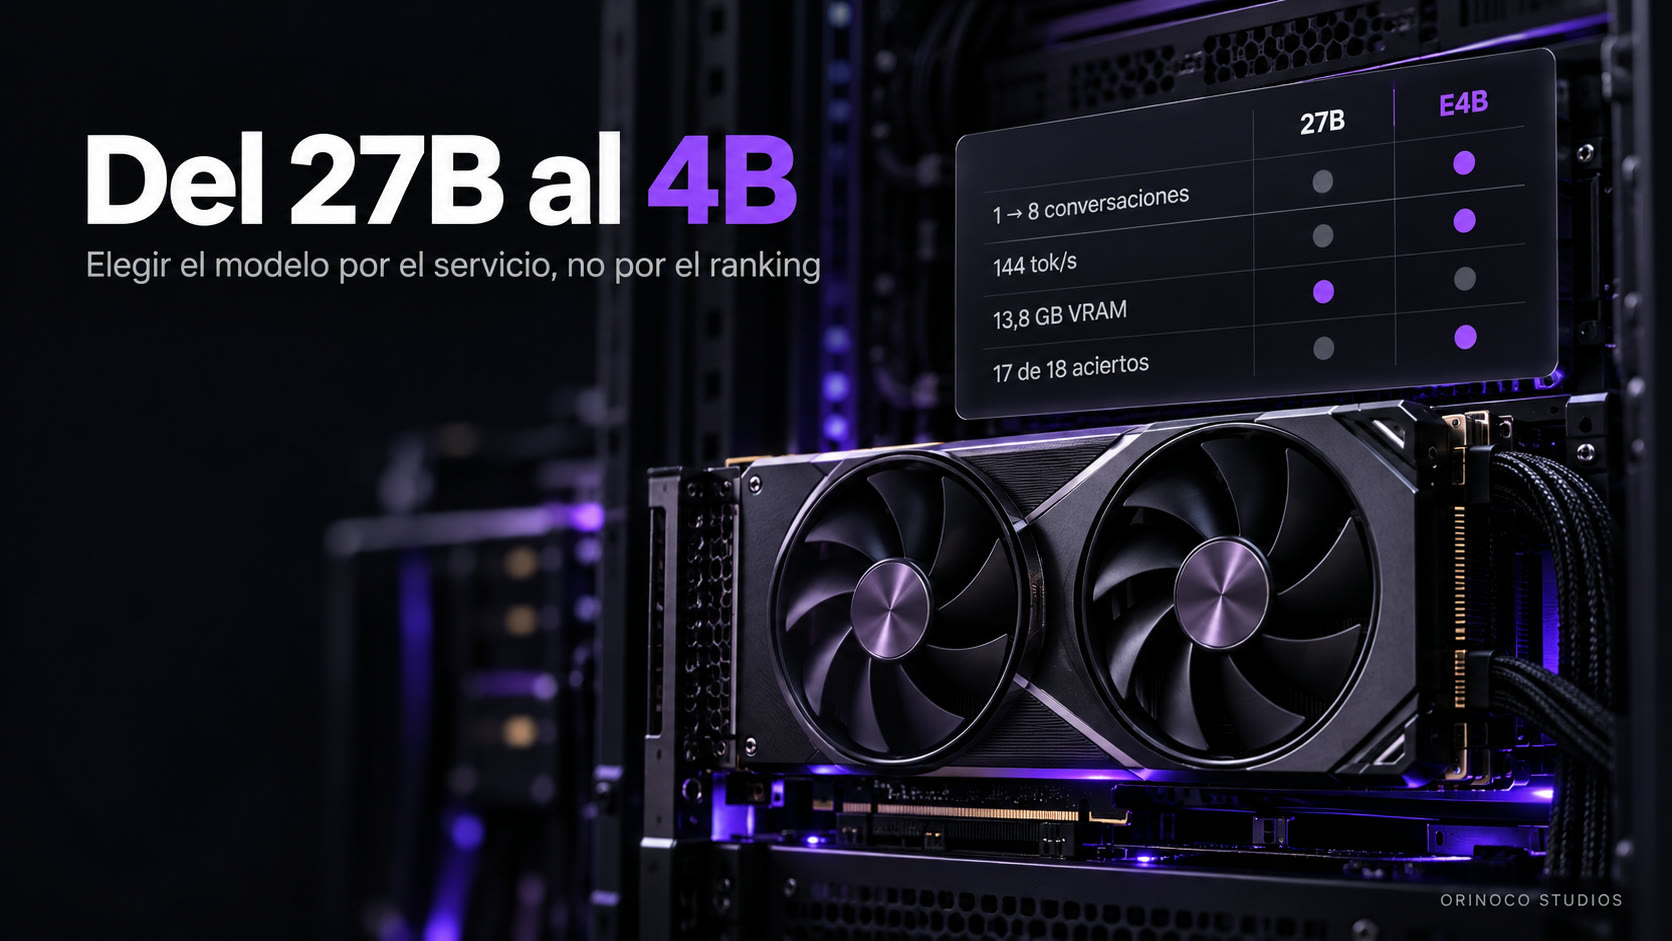
Cambié el modelo de 27.000 millones de parámetros de mi servidor por uno de 4.000 millones y el servicio mejoró. Las cuentas, el banco de pruebas y el interruptor de razonamiento.
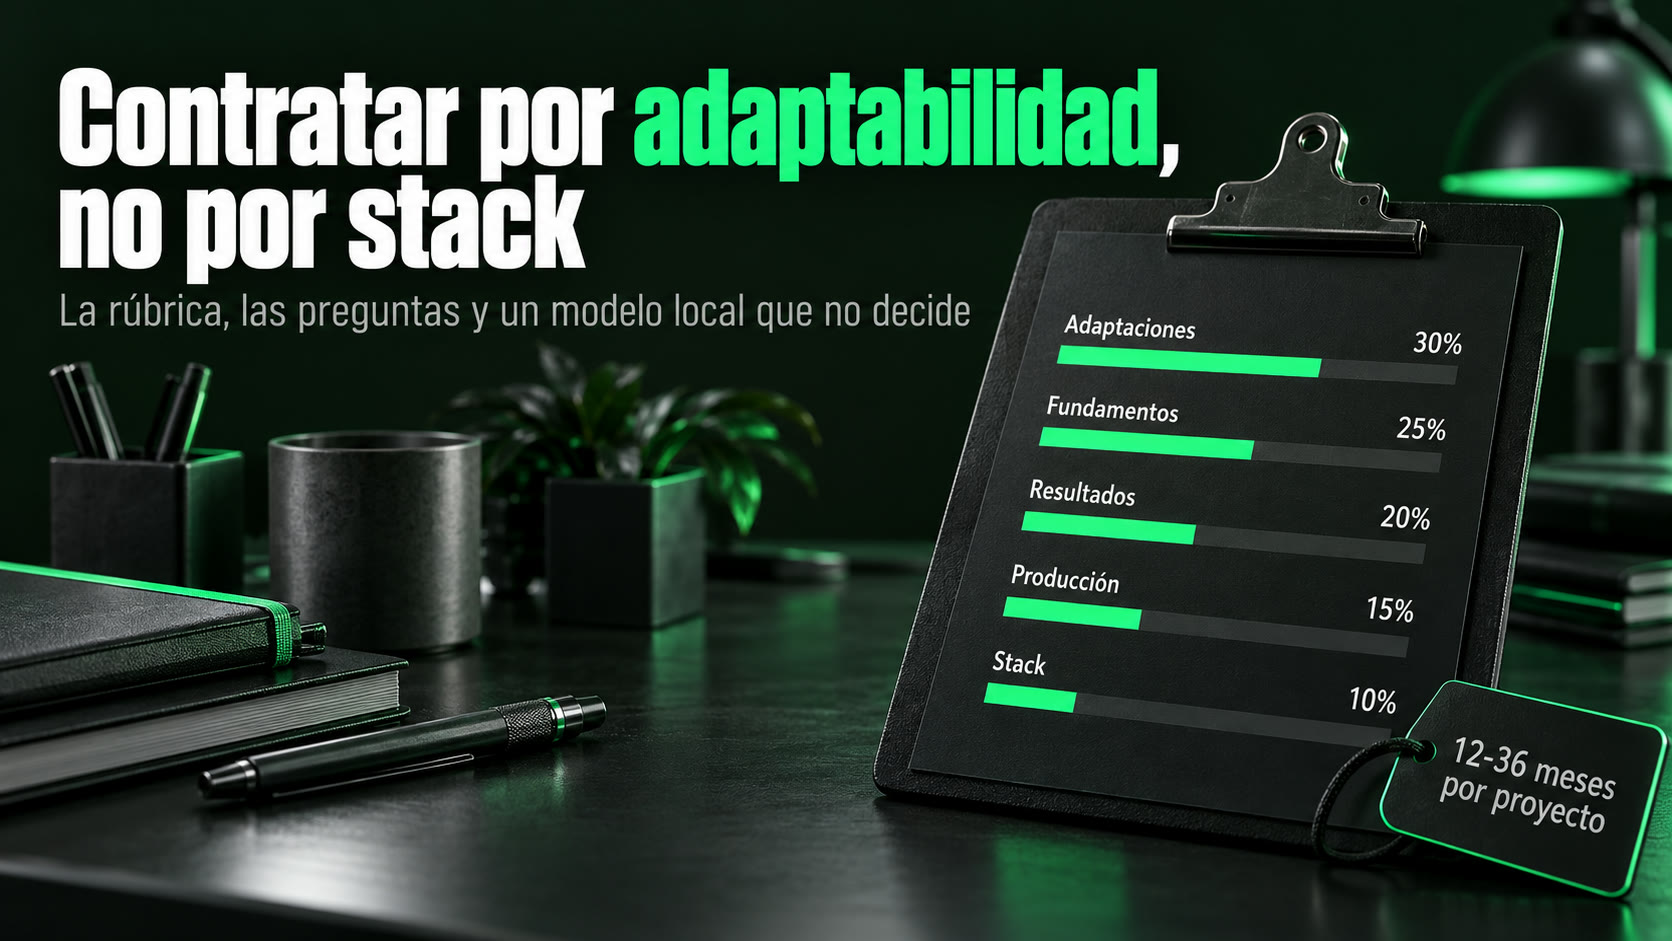
Por qué quitamos AWS de una oferta de backend, la rúbrica con la que puntuamos candidatos y cómo comparamos CVs con un modelo local sin dejar que decida.
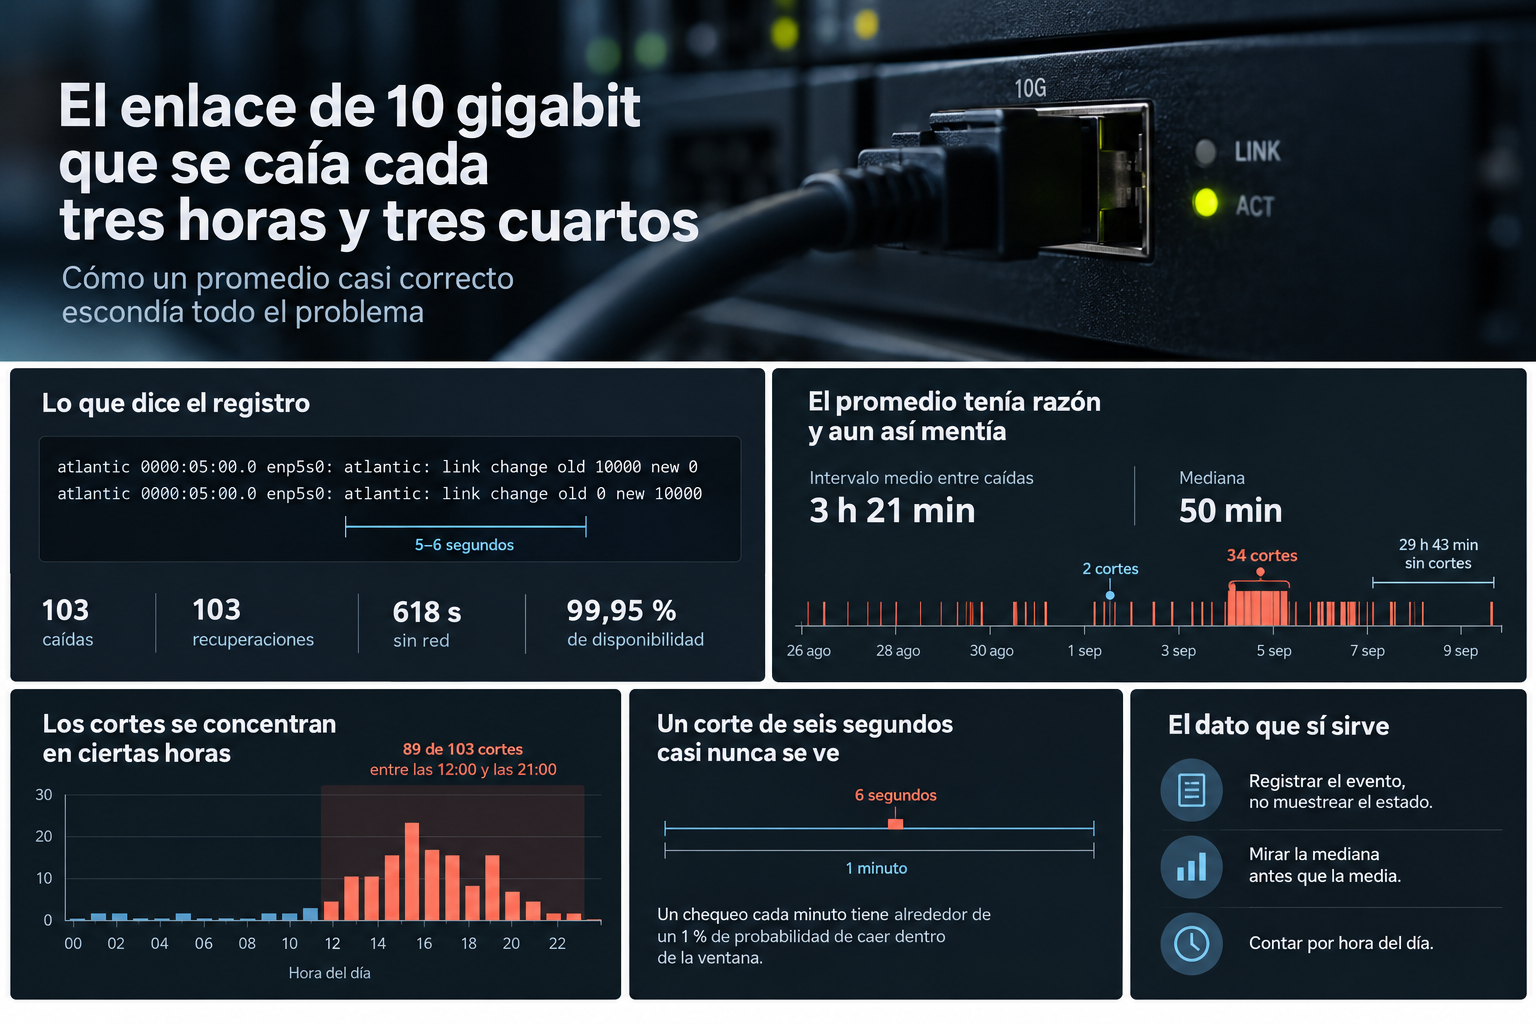
Un enlace de red que se cae seis segundos y vuelve, 103 veces en catorce días. Por qué el promedio y el porcentaje de disponibilidad lo escondían, y qué tiene que ver eso con el usuario al que nadie cree.
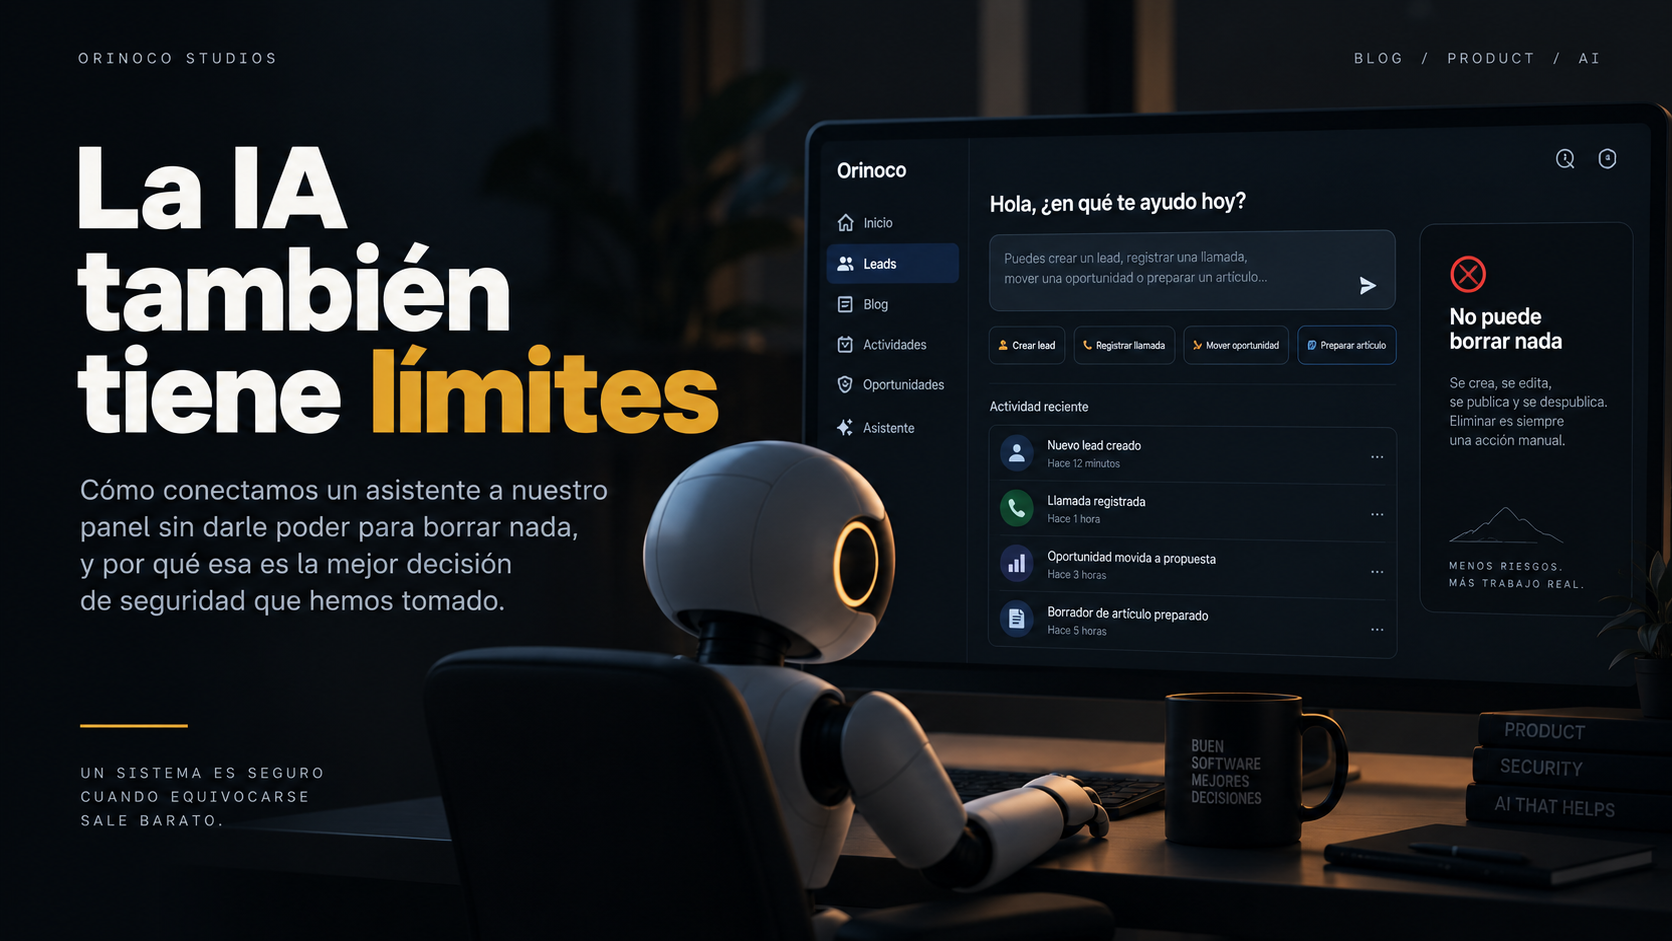
Conectamos un asistente a nuestro CRM y blog con un servidor MCP que no puede borrar nada. Verbos limitados, UUIDs, vocabularios cerrados y datos marcados.
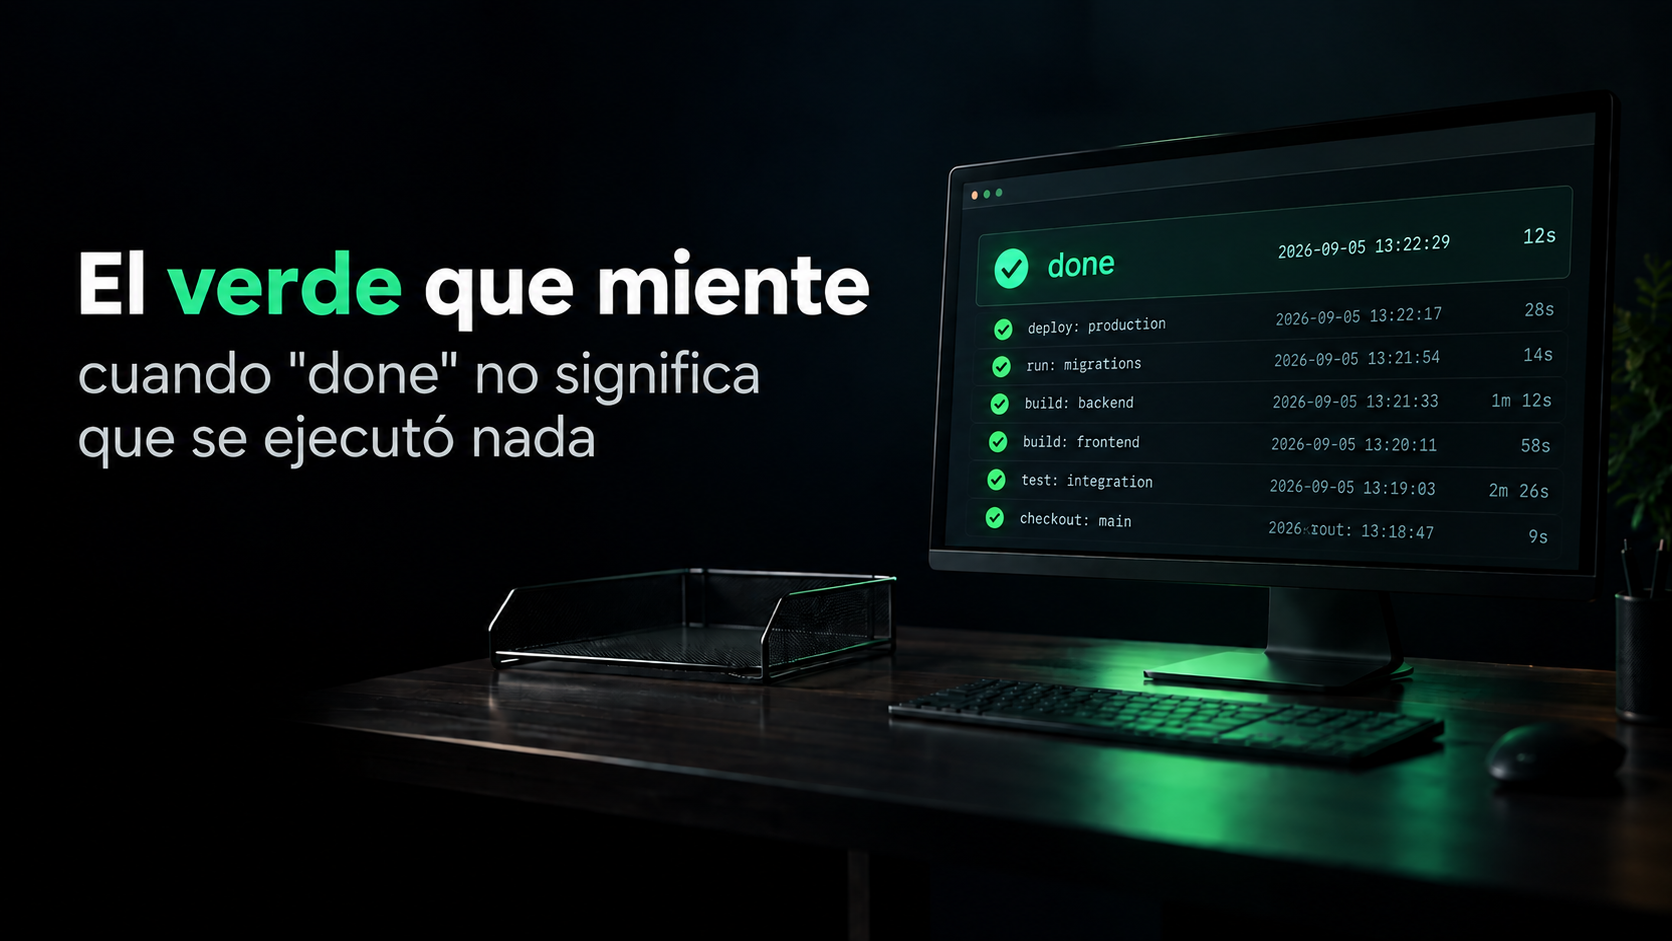
Una tarea programada devolvió «done» y el fichero que debía crear no existía. Qué comprobar cuando un despliegue en verde no prueba nada.
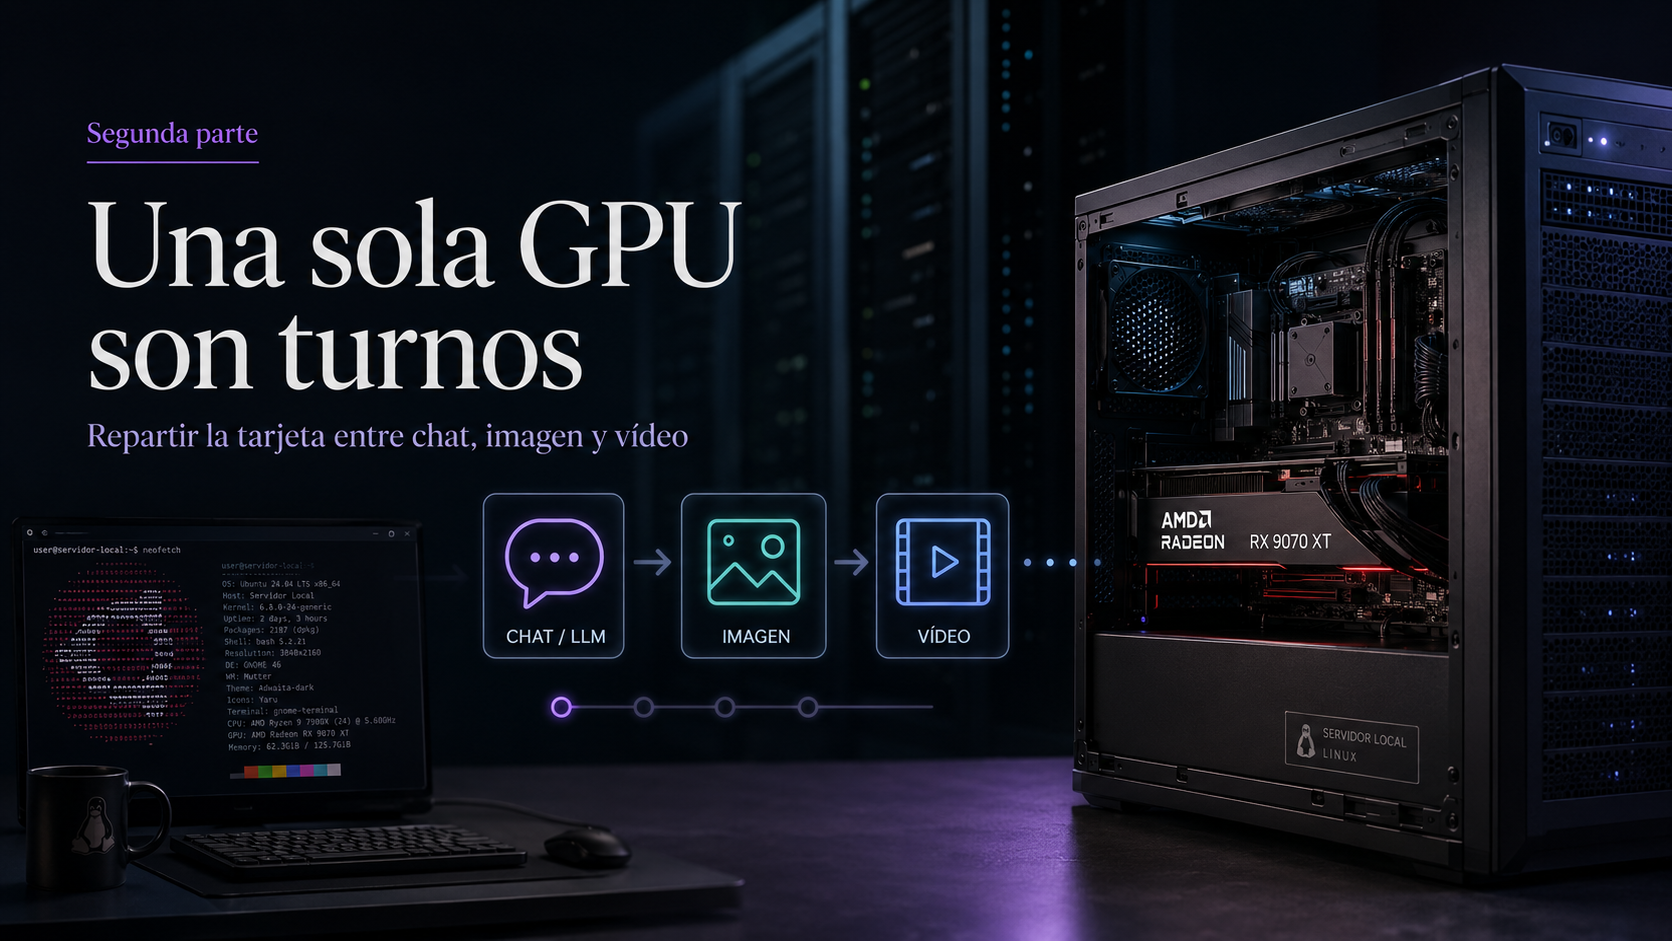
Cómo repartir una sola GPU entre chat, generación de imágenes y vídeo sin bloquear servicios ni dejar procesos colgados.
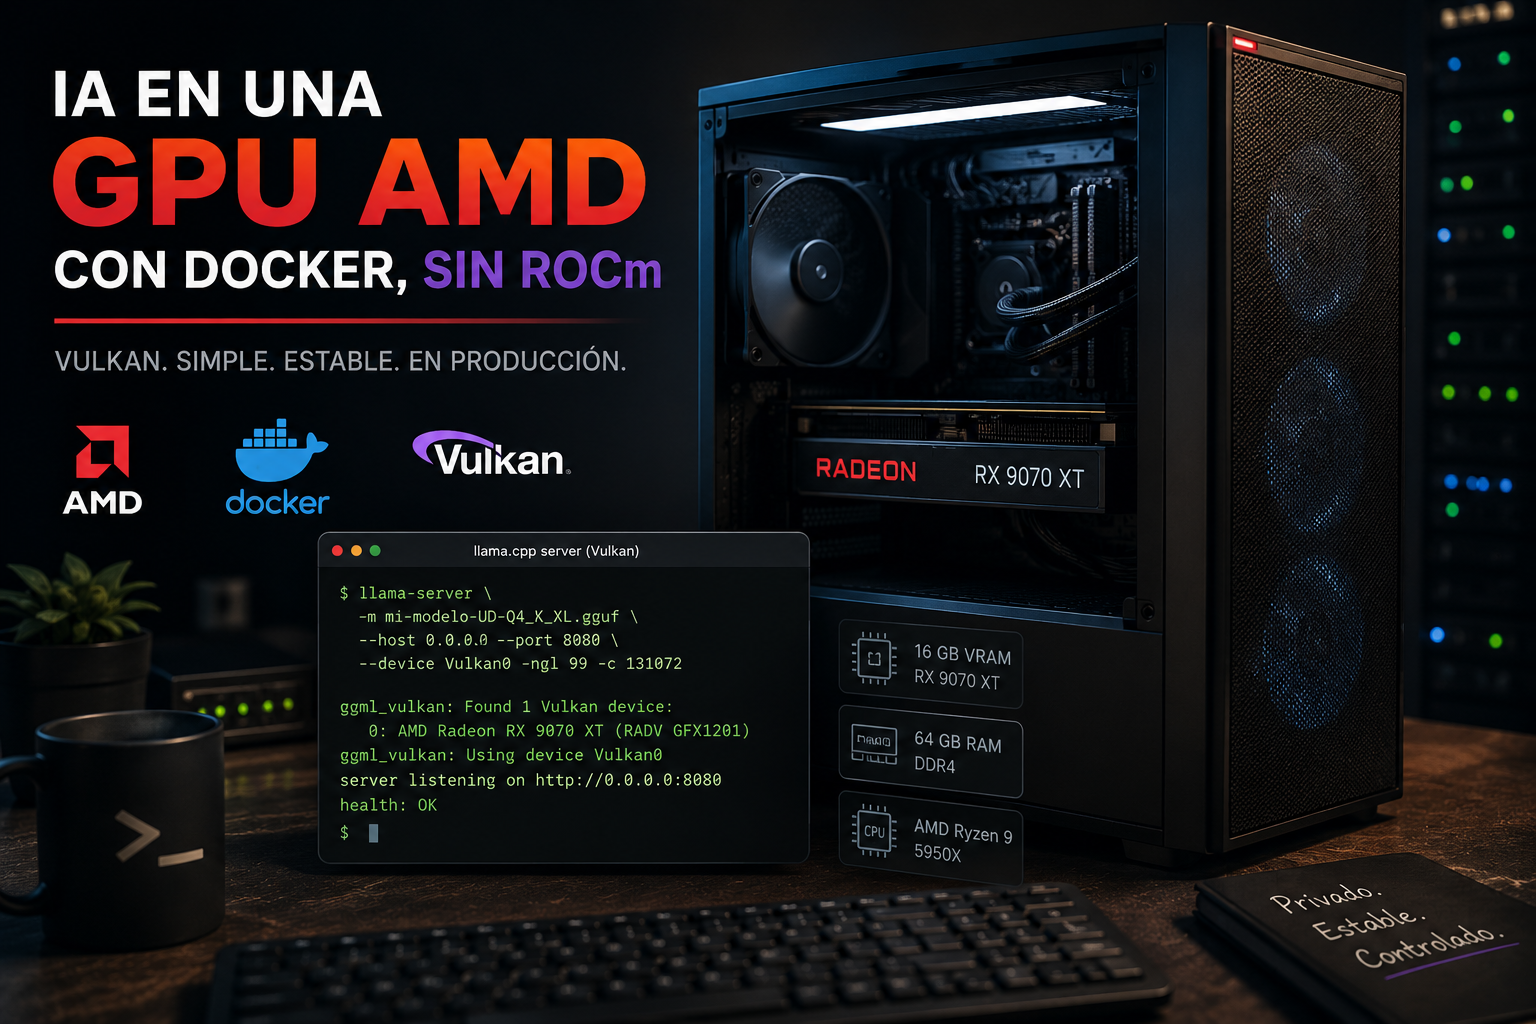
Guías de "instala llama.cpp" hay veinte, y casi todas terminan cuando el modelo responde una vez. Esta empieza ahí: qué hace falta para que el servicio siga levantado tres días después, en una GPU AMD, dentro de Docker y sin pelearse con ROCm. Con las cuatro banderas que parecen adorno y no lo son, y un apartado final sobre por qué en un Mac esto no se puede hacer con Docker.

El problema con el software no es solo su funcionalidad inicial; es la falta de un compromiso con su vida a largo plazo. Mientras muchos proveedores se centran en la entrega y se retiran, nosotros nos centramos en la sostenibilidad del sistema.