
Cuando el despliegue dice «done» y no ha ejecutado nada
El verde que miente: cuando done no significa que se ejecutó nada
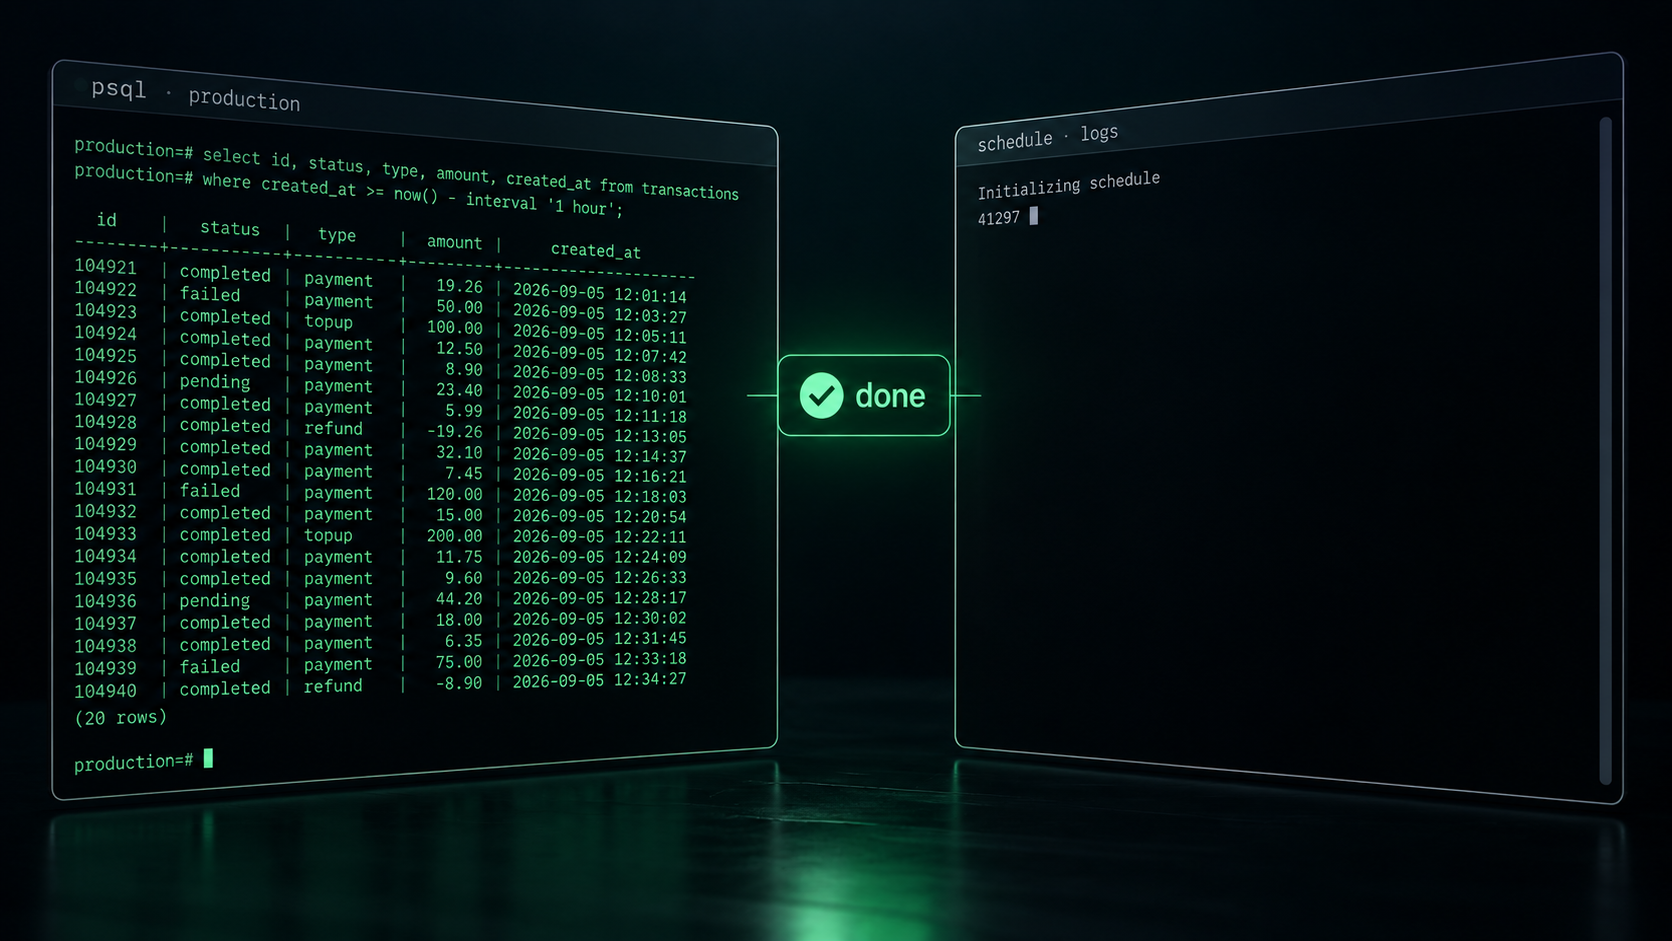
Necesitaba lanzar una consulta SQL contra una base de datos en producción y no tenía acceso directo a ella. El panel de despliegue que usamos permite crear tareas programadas, así que hice lo obvio: una tarea que entrara al contenedor de Postgres y ejecutara la consulta, dejando el resultado en un fichero para poder leerlo después.
Le di a ejecutar. La respuesta fue status: "done", con su
identificador de despliegue, su marca de tiempo y su fila verde en el
historial.
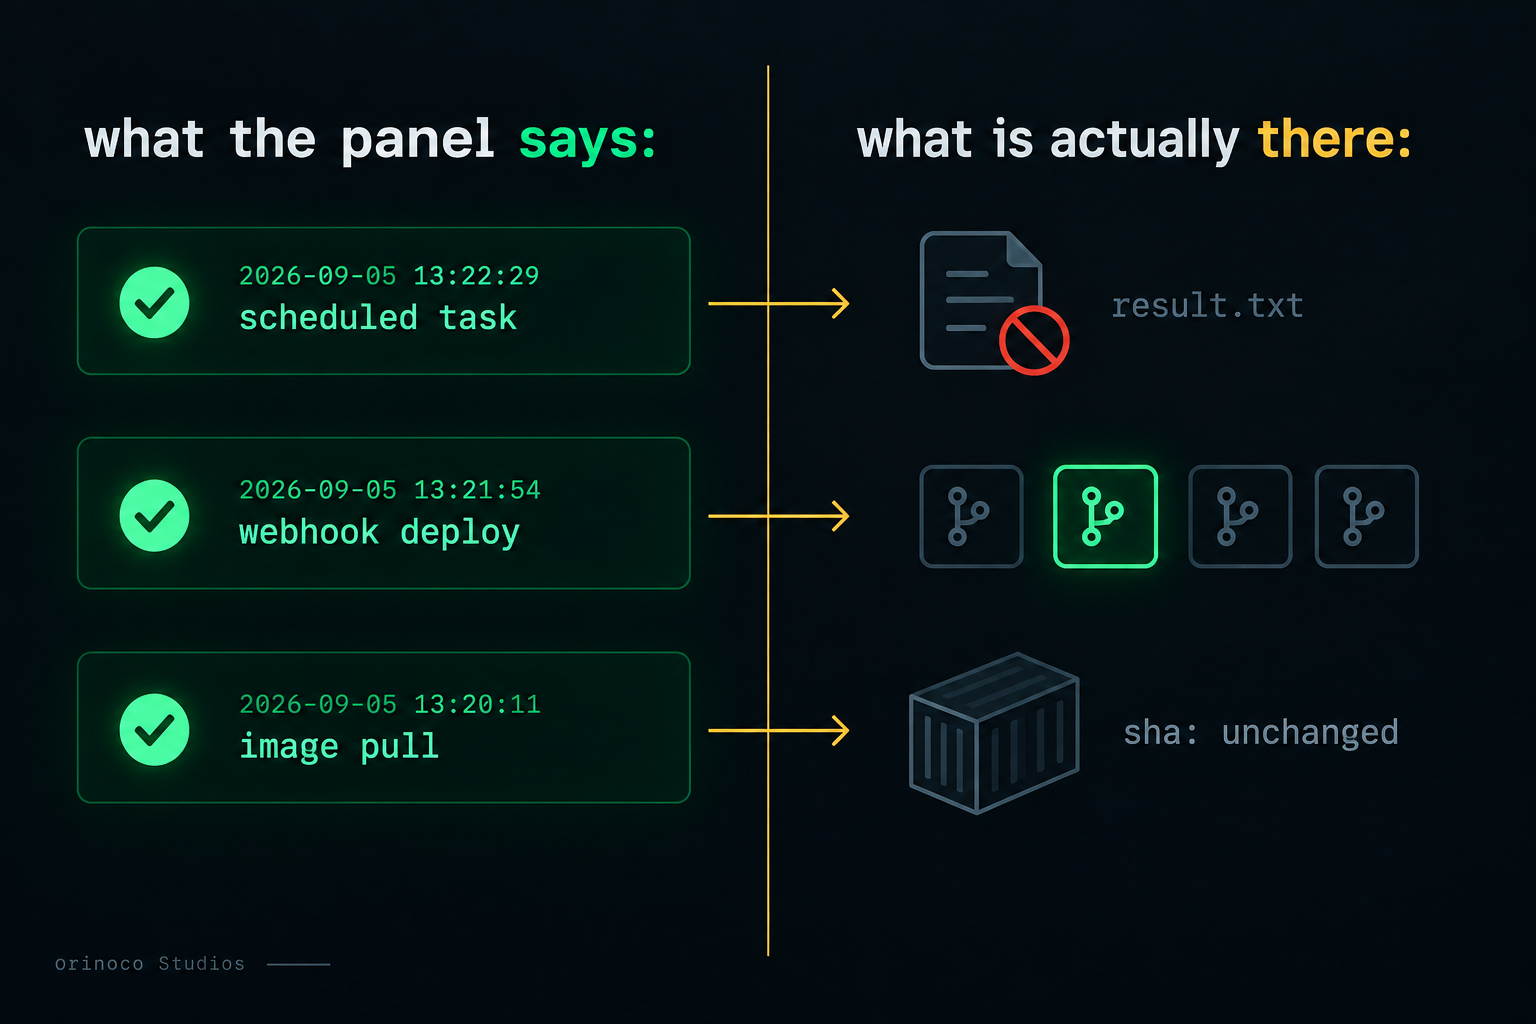
El fichero no existía.
Descartar lo aburrido antes de acusar a nadie
La primera hipótesis siempre es la propia: que el fichero se hubiera escrito en otro sitio, o que la lectura fuera la que fallaba. Eso se comprueba en un minuto, y merece la pena hacerlo antes de escribir un post culpando a una herramienta.
Leí un fichero que existe con seguridad en ese mismo contenedor,
/etc/hostname, con el mismo mecanismo de lectura. Salió a la
primera. La lectura funcionaba. El que no había pasado por ahí era el
comando.
Después fui a los logs de la ejecución, que es donde uno espera encontrar la explicación. Lo que devolvían era esto, entero:
Initializing schedule
<pid>
Ni la salida estándar del comando, ni el error, ni el código de salida. El planificador anota que arranca, anota un PID y ahí se acaba la historia que cuenta.
Con eso, la explicación más probable —y la digo como hipótesis, porque
no he abierto el código del planificador para confirmarla— es que la
tarea se ejecuta dentro del propio contenedor del panel, donde no hay
cliente de docker instalado. El comando falla al instante, nadie
recoge su código de salida, y el planificador informa de lo único que
sabe: que arrancó un proceso. Que arrancó, no que hiciera algo.
Y ahí está el problema de fondo, que es más interesante que el bug concreto: el verde no medía el resultado, medía el lanzamiento.
El mismo patrón, tres veces en un mes
Lo llamativo no fue el caso. Fue reconocerlo.
Diez días antes, un despliegue automático por webhook había fallado del modo más incómodo posible: funcionando a medias. Un agente empujó el mismo cambio a cuatro repositorios seguidos. El webhook disparó para uno. Los otros tres se quedaron donde estaban, en el despliegue del mes anterior, y uno de ellos llevaba una migración de base de datos. En el panel no había ninguna alarma, porque no había ocurrido ningún error: simplemente no había ocurrido nada, y el sistema no tiene forma de mostrar el color de lo que no pasó.
Antes de eso, otro clásico de la casa: desplegar una imagen etiquetada
como latest. Le das a actualizar, el panel se pone a trabajar,
termina en verde, y el contenedor sigue ejecutando exactamente el
mismo código de antes, porque si no se ha publicado una imagen nueva
el digest no ha cambiado y no hay nada que traer. El botón hizo su
trabajo. Lo que no hizo fue lo que tú creías estar pidiendo.
Tres verdes seguidos, y ninguno de los tres mentía técnicamente. Los tres decían la verdad sobre una pregunta que no era la mía.
Y el caso simétrico: el rojo que tampoco significa nada
Conviene contar también el reverso, porque si no esto se queda en una queja contra los paneles.
Copiando un volumen de datos en caliente —con los ficheros cambiando
mientras se leen—, tar termina con código de salida 1. Un pipeline
de integración continua ve ese 1 y aborta el proceso. Y sin embargo la
copia suele estar perfectamente bien: tar avisa de que un fichero
cambió mientras lo leía, que es exactamente lo que esperabas que
pasara al copiar en caliente.
Ahí el código de salida es pesimista, igual que el done de antes era
optimista. La lección es la misma en los dos sentidos: el estado que
devuelve una herramienta responde a la pregunta que esa herramienta se
hace, no a la tuya. Tu pregunta casi nunca es "¿arrancó el proceso?"
ni "¿hubo algún aviso?". Tu pregunta es "¿está el dato donde tiene que
estar?".
Qué hacemos ahora, que es aburrido a propósito
No hay ninguna arquitectura elegante detrás de esto. Hay tres costumbres:
1. Toda automatización deja un rastro que se pueda comprobar por fuera. Si una tarea tiene que escribir un fichero, se lee el fichero. Si tiene que tocar una tabla, se consulta la tabla. Si tiene que desplegar una versión, se pregunta a la aplicación en marcha qué versión está sirviendo. La comprobación no puede venir del mismo sistema que hizo el trabajo, porque entonces estás preguntándole a alguien si ha hecho los deberes.
2. Nada se despliega por etiqueta móvil. Se despliega por commit:
sha-<commit>. Con una etiqueta fija, "no ha cambiado nada" y "ha
desplegado lo de siempre" son estados distinguibles a simple vista.
Con latest son el mismo píxel verde.
3. Cuando hay que ejecutar algo de verdad en producción, se ejecuta por un camino que devuelve salida. En el caso del SQL, lo que acabó funcionando fue abrir un puerto externo temporal y conectarse con un cliente de Postgres desde fuera: menos cómodo que la tarea programada, pero cuando escribe, lo dice, y cuando falla, también. La alternativa buena a largo plazo es que ese cambio viaje como una migración versionada, con lo cual deja de ser una operación manual y pasa a ser código revisable.
Por qué esto es un asunto de negocio y no de sistemas
Porque el coste de un fallo silencioso no lo paga quien lo provocó, lo paga el usuario, y con retraso.
Los tres verdes de arriba tienen la misma forma: un despliegue que no llegó a producción con una migración dentro, una tarea que no corrigió los datos que decía haber corregido, una versión que lleva un mes sin actualizarse en el servidor. Ninguno de los tres se nota el día que pasa. Se notan semanas después, cuando alguien abre una incidencia rarísima y el equipo pierde una mañana entera buscando un bug que no existe, porque el bug estaba arreglado; lo que no estaba era desplegado.
Uno de nuestros compromisos es la detección temprana: ver los fallos antes de que el cliente los reporte. Cumplirlo no consiste en montar más paneles. Consiste en desconfiar de los que ya hay, y quedarse con los indicadores que miden un efecto en el mundo y no la buena intención de un proceso.
Un panel en verde no es una prueba. Es una opinión.