
Seis segundos, ciento tres veces
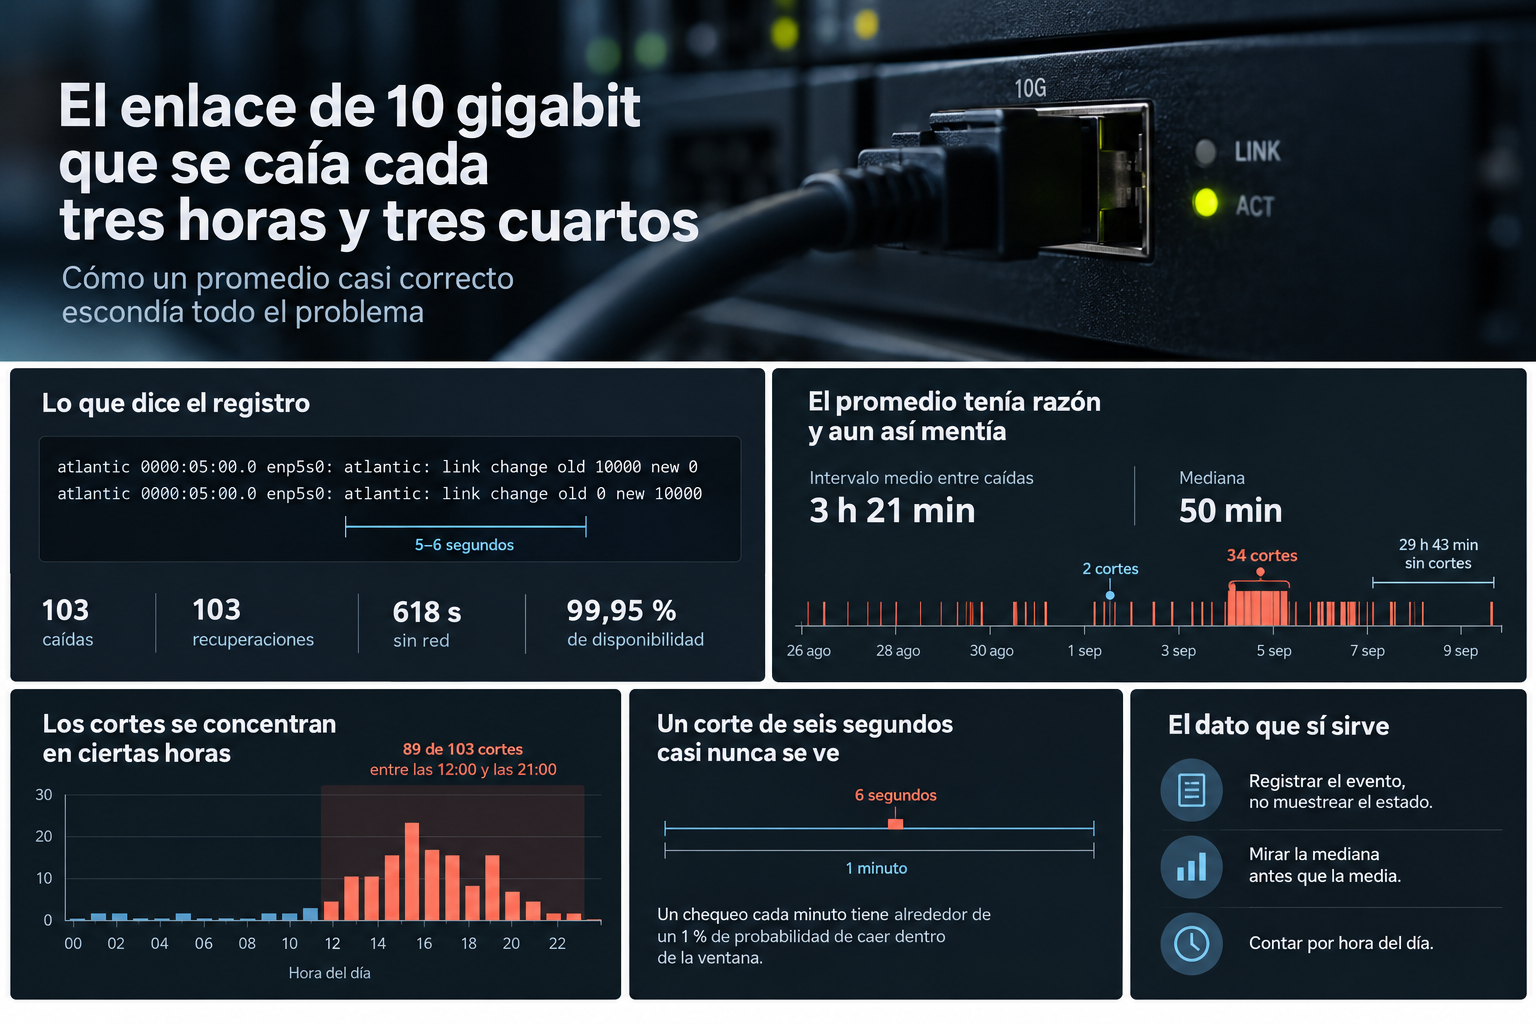
Teníamos una nota apuntada desde hace semanas: "el enlace de 10 gigabit del servidor se cae cada tres horas y tres cuartos". Iba a ser el punto de partida de este artículo. Antes de escribirlo, fuimos a leer el registro del sistema.
La nota casi acertaba. Y por eso mismo no servía para nada.
Lo que dice el registro
Del 26 de agosto al 9 de septiembre —catorce días de funcionamiento continuo— el kernel anotó 103 caídas del enlace y 103 recuperaciones. Cada una son dos líneas:
atlantic 0000:05:00.0 enp5s0: atlantic: link change old 10000 new 0
atlantic 0000:05:00.0 enp5s0: atlantic: link change old 0 new 10000
Entre una y otra pasan siempre cinco o seis segundos. Ni un corte más largo, ni uno más corto. Ciento tres veces el mismo comportamiento.
Sumado: 618 segundos sin red en catorce días. Diez minutos y dieciocho segundos. Un 99,95 % de disponibilidad, que en cualquier panel se pinta en verde y en cualquier contrato se firma sin discutir.
El promedio tenía razón y aun así mentía
Aquí está la parte interesante. La nota decía "cada tres horas y tres cuartos". El intervalo medio real entre caídas es de tres horas y veintiún minutos. Casi clavado. Alguien había hecho bien la división.
El problema es que la mediana es de cincuenta minutos.
Cuando la media y la mediana se separan tanto, el promedio ha dejado de describir el sistema. Y en este caso lo que esconde es el patrón entero: el fallo no es periódico, es a ráfagas. El 5 de septiembre hubo 34 cortes. El 2 de septiembre hubo 2. En algún momento el enlace aguantó 29 horas y 43 minutos seguidos sin caerse ni una vez.
Y hay ráfagas dentro de las ráfagas. El 7 de septiembre a las 12:56:18 cayó el enlace; a las 12:56:24 volvió; a las 12:56:27 volvió a caerse. Dos cortes completos en quince segundos.
Un promedio de tres horas describe un sistema que falla un par de veces por turno de trabajo, molesto pero llevadero. La realidad es que hay tardes en las que se cae cada veinte minutos y días enteros en los que no se cae nunca. Son dos averías distintas, con dos causas distintas y dos formas distintas de buscarlas. El promedio las funde en una que no existe.
El dato que sí sirve
Al contar los cortes por hora del día apareció lo que buscábamos: 89 de los 103 ocurren entre las doce del mediodía y las nueve de la noche. Entre medianoche y las ocho de la mañana hubo cinco cortes. Cinco. En catorce días.
Eso no dice cuál es la causa. Dice dónde buscarla: en algo que correlaciona con la actividad de la máquina y del edificio, no con el reloj. Temperatura, carga, consumo, el otro extremo del cable. Todavía no lo sabemos, y no vamos a escribir aquí una causa que no hemos confirmado.
Lo que sí ha cambiado es que el fallo dejó de ser invisible.
Por qué esto no va de nuestro rack
Un corte de seis segundos tiene una propiedad incómoda: no aparece en ningún sitio donde se le suela buscar.
- Un chequeo automático cada minuto tiene alrededor de un 1 % de probabilidad de caer dentro de la ventana. De 103 cortes, detectaría uno.
- Un panel de disponibilidad lo resume como 99,95 % y lo pinta en verde.
- Una copia de seguridad o una sincronización nocturna casi nunca lo pisa, porque a esas horas apenas ocurre.
- Y la persona que lo sufre lo describe como "a veces se me corta": sin hora, sin captura de pantalla, sin nada que enseñar.
Ahí es donde esto se convierte en un problema de relación y no de red. El proveedor mira su panel, ve verde y contesta "a mí me funciona". El usuario aprende que reportar no sirve de nada y deja de reportar. El fallo sigue estando, solo que ahora nadie lo cuenta. Y el día que rompa algo grande, nadie tendrá los catorce días de historial que hacían falta para entenderlo.
Tenemos una regla que decimos mucho: si el software confunde al usuario, el problema es del software, nunca del usuario. Esta es su versión aplicada a la infraestructura: si alguien dice que se corta y tu panel dice que no, el que está mal es el panel.
Qué nos llevamos de aquí
Tres cosas, y ninguna es cara:
Registrar el evento, no muestrear el estado. El sistema llevaba semanas escribiendo cada caída con su marca de tiempo al segundo. No hubo que instalar nada ni pagar nada: hubo que ir a leerlo. La diferencia entre preguntar "¿estás bien?" cada minuto y escuchar lo que el sistema ya está diciendo es la diferencia entre ver un corte y ver ciento tres.
Mirar la mediana antes que la media. En cuanto un fallo se agrupa —y casi todos se agrupan— el promedio deja de describir nada. Si las dos cifras se separan, la interesante es siempre la que no estabas mirando.
Contar por hora del día. Es la agrupación más barata que existe y es la que convirtió un ruido sin forma en una pista concreta.
Y una cuarta, que es de honestidad: este fallo lleva ocurriendo desde el 26 de agosto y lo hemos mirado en serio hoy. Contarlo entero, incluida esa parte, también forma parte de cómo queremos trabajar. Creemos que ninguna empresa debería tener que elegir entre software que funciona y un proveedor que coge el teléfono, y coger el teléfono empieza por creerse al que llama.
