
Servir un modelo de IA en una GPU AMD con Docker, sin ROCm
Guías de "instala llama.cpp" hay veinte. Casi todas terminan cuando el modelo responde una vez por la línea de comandos. Esta empieza ahí y sigue hasta lo que de verdad cuesta: que el servicio siga levantado tres días después, en una GPU AMD, dentro de Docker y sin pelearse con ROCm.
Todo lo que hay aquí está sacado de un servidor real en funcionamiento. El hardware concreto es un AMD Ryzen 9 5950X con 64 GB de RAM y una Radeon RX 9070 XT de 16 GB, sobre AlmaLinux 10 sin entorno gráfico. Nada de esto es específico de esa combinación salvo donde se avisa.
Por qué Vulkan y no ROCm
La respuesta corta: porque funciona hoy y con menos piezas.
ROCm es la vía oficial de AMD para cómputo, y para tarjetas de la generación RDNA 4 el soporte llegó tarde y a trozos. vLLM, que es lo que usarías en una NVIDIA para servir en producción, no tiene núcleos de cómputo para RDNA 4: puedes instalarlo y no vas a conseguir que use la tarjeta.
llama.cpp tiene un backend Vulkan que no depende de ROCm, sino del mismo driver gráfico que ya usa el sistema. Eso significa una dependencia menos, imágenes de Docker más pequeñas y, sobre todo, que una actualización del kernel no te deja el servicio muerto.
El precio: Vulkan rinde algo menos que un backend nativo bien ajustado, y no tienes las optimizaciones de servidor de vLLM. Para servir un modelo mediano a un puñado de usuarios simultáneos, sobra.
1. Comprobar que el sistema ve la tarjeta
Antes de instalar nada, tres comprobaciones. Si alguna falla, el resto no tiene sentido.
# ¿Está el driver del kernel cargado?
lsmod | grep amdgpu

# ¿Existen los dispositivos que necesita el contenedor?
ls -l /dev/dri /dev/kfd

# ¿Vulkan ve la tarjeta como GPU discreta?
vulkaninfo --summary | grep -E 'deviceName|driverName'
La última es la importante. La salida correcta menciona tu tarjeta y el driver
radv:
deviceName = AMD Radeon RX 9070 XT (RADV GFX1201)
driverName = radv
deviceName = llvmpipe (LLVM 21.1.8, 256 bits)
driverName = llvmpipe
Fíjate en que hay dos dispositivos. El segundo, llvmpipe, es el
renderizador por software: no es una tarjeta, es tu CPU fingiendo ser una. Está
presente en casi cualquier Linux con Mesa instalado, y dentro de un rato va a
ser el origen del error más desconcertante de esta guía.
Si vulkaninfo solo lista llvmpipe, te falta el driver: instala
mesa-vulkan-drivers y vulkan-tools, y reinicia.
2. Permisos: el error que parece de Docker y no lo es
El contenedor necesita acceso a /dev/dri (el dispositivo de render) y a
/dev/kfd (la interfaz de cómputo). Ambos pertenecen a grupos del sistema, así
que tu usuario tiene que estar en ellos:
sudo groupadd -f render
sudo groupadd -f video
sudo usermod -aG render,video,docker $USER
Y después cierra sesión y vuelve a entrar. Un usermod no afecta a las
sesiones ya abiertas, y este es probablemente el motivo número uno por el que
alguien concluye que "Docker no ve la GPU". Para comprobarlo sin reiniciar:
id | tr ' ' '\n' | grep -E 'render|video'
3. El modelo: la cuantización importa más de lo que parece
Un modelo en formato GGUF viene cuantizado: los pesos se guardan con menos bits para que quepan en la memoria de la tarjeta. Aquí hay una decisión que mucha gente pasa por alto.
Las cuantizaciones clásicas (Q4_0 y compañía) aplican la misma precisión a
todas las capas. Las cuantizaciones dinámicas —las que publica unsloth con
el prefijo UD-— dan más bits a las capas que más lo notan y menos a las que no.
A igualdad de tamaño en disco, la calidad de las respuestas es mejor. No hay
truco ni coste: es el mismo fichero, mejor repartido.
En el servidor del ejemplo, el modelo de chat ocupa 2,6 GB en disco y unos 3,6 GB de memoria de la tarjeta una vez cargado, de los 16 disponibles. Eso deja sitio de sobra para lo demás, que es justo lo que buscábamos.
Descárgalo donde quieras; aquí van a ~/models:
mkdir -p ~/models
cd ~/models
# Sustituye por el modelo y la cuantización que te encajen.
curl -L -C - -O "https://huggingface.co/<repo>/resolve/main/<modelo>-UD-Q4_K_XL.gguf"
4. El fichero de Docker Compose
Este es el servicio de chat, con todas las banderas que importan:
services:
  llama-chat:
    image: ghcr.io/ggml-org/llama.cpp:server-vulkan
    container_name: llama-chat
    restart: unless-stopped
    ports:
      - "8083:8080"
    volumes:
      - /home/usuario/models:/models:ro
    devices:
      - /dev/dri:/dev/dri
      - /dev/kfd:/dev/kfd
    environment:
      - GGML_VULKAN_DISABLE_CPU_FALLBACK=1
    healthcheck:
      test: ["CMD-SHELL", "curl -fsS http://localhost:8080/health || exit 1"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 180s
    command: >
      --host 0.0.0.0 --port 8080
      --device Vulkan0
      -m /models/mi-modelo-UD-Q4_K_XL.gguf
      -ngl 99
      -c 131072
      --parallel 6
      --flash-attn on
      -t 16
      --jinja
Levántalo:
docker compose up -d llama-chat
docker logs -f llama-chat
5. Las cuatro líneas que no puedes quitar
El bloque de arriba tiene cuatro decisiones que parecen adorno y no lo son. Son las que separan "me funcionó una vez" de "lleva tres días levantado".
--device Vulkan0
La más importante, y la que nadie cuenta. ¿Recuerdas que vulkaninfo
listaba dos dispositivos? Si no le dices cuál usar, llama.cpp intenta repartir el
modelo entre todos los que ve — incluido el renderizador por software— y aborta
al arrancar con un error que no dice nada útil:
GGML_ASSERT(n_inputs < GGML_SCHED_MAX_SPLIT_INPUTS) failed
No es un problema de memoria ni del modelo: es que está intentando trocear el modelo entre tu tarjeta y tu CPU. Fijas el dispositivo y desaparece.
Comprueba antes cuál es el tuyo: el orden de vulkaninfo --summary es el mismo
que usa llama.cpp, así que si tu tarjeta sale la primera, es Vulkan0.
GGML_VULKAN_DISABLE_CPU_FALLBACK=1
Sin esto, cuando una operación no está soportada por el backend Vulkan, se resuelve en la CPU en silencio. No falla: se vuelve lento. Un día tienes el servicio a la mitad de velocidad y ningún error que lo explique. Con la variable puesta, si algo no se puede hacer en la tarjeta te enteras al arrancar y no seis semanas después.
Es la diferencia entre un fallo ruidoso y una degradación silenciosa. Prefiere siempre el ruidoso.
start_period: 180s en el healthcheck
Cargar un modelo en la memoria de la tarjeta tarda. Si el healthcheck empieza a comprobar desde el segundo cero, marcará el contenedor como enfermo, Docker lo reiniciará, la carga volverá a empezar, y así indefinidamente: un bucle de reinicio provocado exactamente por la comprobación que debía protegerte.
Tres minutos de gracia es un valor conservador que funciona incluso con modelos grandes. Ajústalo a la baja cuando sepas lo que tarda el tuyo.
-ngl 99
Le dice que suba todas las capas a la tarjeta. Si el modelo no cabe entero, lo que hace no es fallar: reparte lo que no cabe a la CPU y sigue funcionando, mucho más despacio. Vigila la memoria usada después de arrancar, porque un modelo que "va lento" casi siempre es un modelo que no cupo:
watch -n1 'echo $(( $(cat /sys/class/drm/card*/device/mem_info_vram_used) / 1048576 )) MiB'
6. Comprobar que responde de verdad
El servidor de llama.cpp expone una API compatible con la de OpenAI, así que cualquier cliente que hable ese protocolo vale sin tocar código:
# ¿Vivo?
curl -s http://127.0.0.1:8083/health

# ¿Responde?
curl -s http://127.0.0.1:8083/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"Dime una frase corta."}]}'
Esa compatibilidad es la decisión de diseño que más rentabilidad da a largo plazo: cambiar de modelo, o volver mañana a un proveedor comercial, es tocar una variable de entorno y no reescribir la aplicación.
7. Embeddings: un segundo contenedor, no el mismo
Si además necesitas búsqueda por significado, la tentación es reutilizar el modelo de chat. No funciona bien: un modelo entrenado para conversar no es un buen generador de vectores, y las arquitecturas modernas de mezcla de expertos directamente no encajan con el promediado que requieren los embeddings.
La solución es un segundo contenedor con un modelo específico, que es diminuto —unos 95 MB— y comparte la misma tarjeta sin despeinarse:
  llama-embed:
    image: ghcr.io/ggml-org/llama.cpp:server-vulkan
    container_name: llama-embed
    restart: unless-stopped
    ports:
      - "8082:8080"
    volumes:
      - /home/usuario/models/embeddings:/models:ro
    devices:
      - /dev/dri:/dev/dri
      - /dev/kfd:/dev/kfd
    command: >
      --host 0.0.0.0 --port 8080
      -m /models/nomic-embed-text-v1.5.Q5_K_M.gguf
      -ngl 99
      --embedding
      --pooling mean
      -t 8
Quedan dos servicios en dos puertos. Si quieres una sola dirección para ambos,
un proxy de veinte líneas que mande /v1/embeddings a uno y todo lo demás al
otro resuelve el problema sin añadir dependencias.
8. Acelerar con predicción de varios tokens
Una vez que funciona, hay una mejora que cuesta un fichero extra y da bastante: la generación especulativa. Un modelo pequeño propone varios tokens y el grande los valida de golpe, en lugar de ir uno a uno.
Con un modelo que publique su propio fichero de predicción, son tres líneas:
      --model-draft /models/mtp-mi-modelo.gguf
      --spec-type draft-mtp
      --spec-draft-n-max 4
Ojo: el fichero de predicción tiene que corresponder al modelo exacto que estás sirviendo. No todos los publican, y ese es un motivo perfectamente válido para elegir un modelo en vez de otro.
9. Qué hacer cuando la tarjeta hace falta para otra cosa
Con una sola tarjeta no hay concurrencia, hay turnos. Si además vas a generar imágenes o vídeo, esos modelos no caben junto al de chat, y la única salida es pararlo, generar y devolverlo.
Si automatizas eso, la parte que no puedes olvidar es la restauración. Hazla saltar cuando el proceso termina —también cuando termina mal— y no como último paso del guion. La diferencia se ve el día que la generación falla a la mitad: con la restauración enganchada a la salida, el chat vuelve; sin ella, se queda caído y nadie se entera hasta que alguien escribe.
10. ¿Y en un Mac?
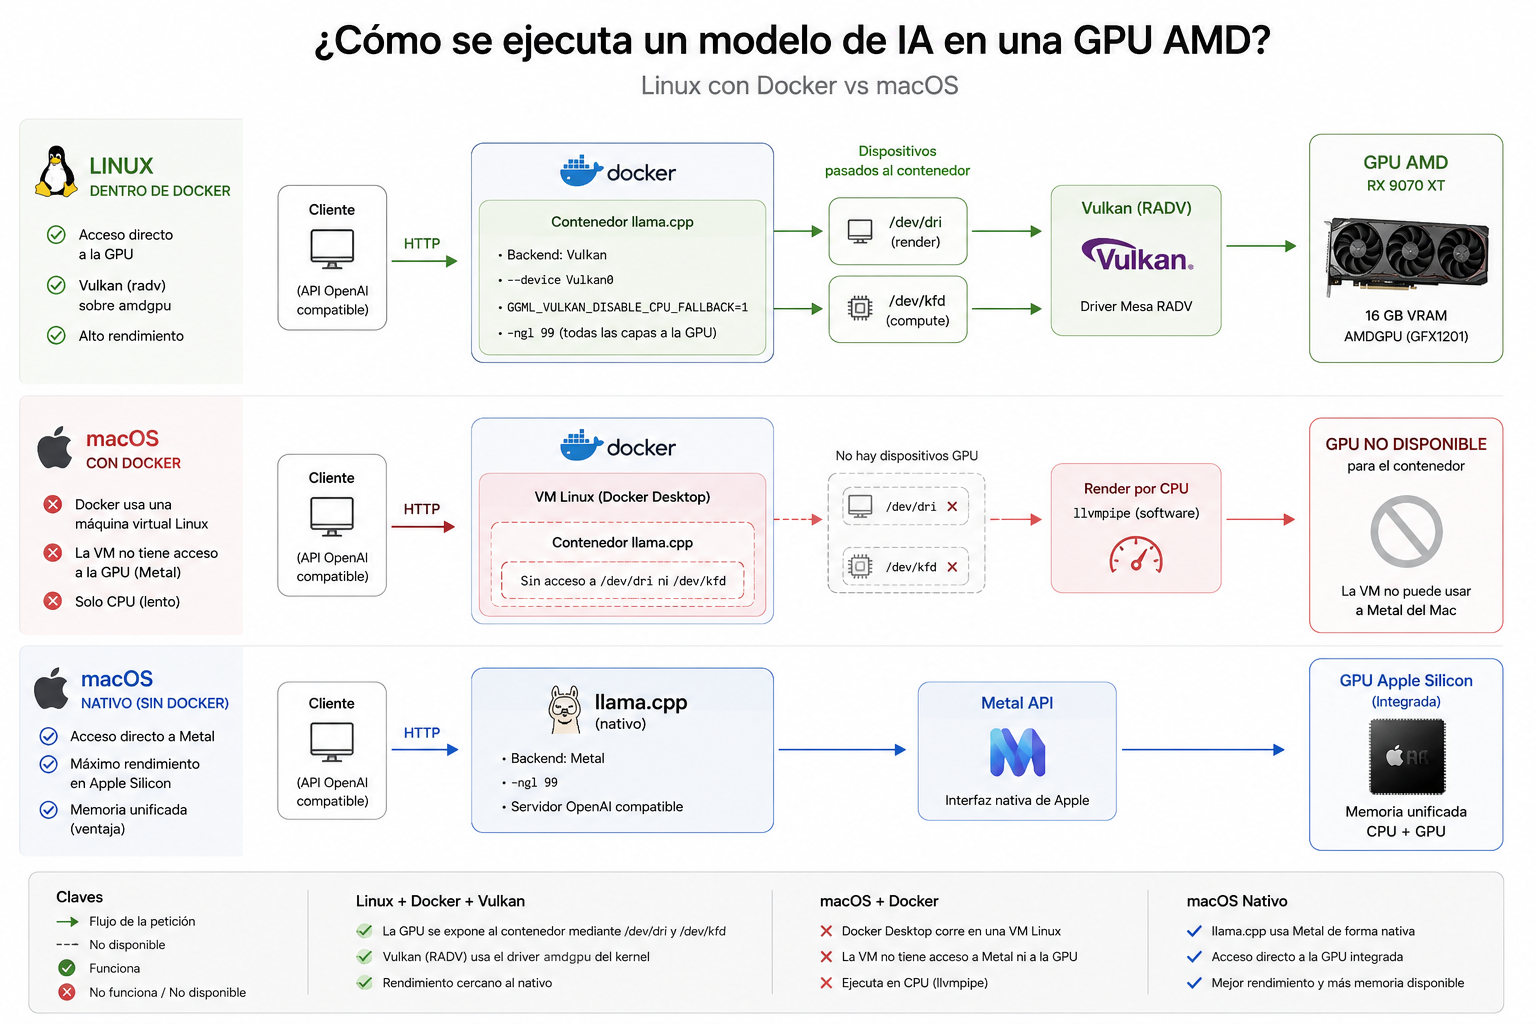
Aquí toca dar una mala noticia antes que una receta: en macOS, este artículo no aplica tal cual, y el motivo no es un ajuste que se te haya escapado.
Docker en un Mac no ejecuta contenedores sobre el sistema: levanta una máquina virtual con Linux dentro y los ejecuta ahí. Esa máquina virtual no tiene acceso a la GPU del Mac — Metal, la interfaz gráfica y de cómputo de Apple, no se pasa al interior.
No es una opinión. Medido en un Mac mini con M4 Pro y 24 GB de memoria unificada, macOS 26.5.2, Docker Desktop 29.6.2:
Dentro del contenedor no existe ningún dispositivo gráfico. El listado de
/dev no tiene /dev/dri ni nada equivalente. En Linux pasábamos ese
dispositivo al contenedor porque existe; aquí no hay nada que pasar.
Pedir la GPU explícitamente falla en seco:
$ docker run --rm --gpus all ...
docker: Error response from daemon: failed to discover GPU vendor from CDI:
no known GPU vendor found
Y el motor de inferencia, ya dentro, lo confirma en su propio arranque:
msg="discovering available GPUs..."
msg="inference compute" id=cpu library=cpu name=cpu total="3.8 GiB"
msg="vram-based default context" total_vram="0 B" default_num_ctx=4096
Fíjate en library=cpu y en total_vram="0 B". Y fíjate también en el otro
dato, que suele pillar por sorpresa: los 3.8 GiB no son los 24 GB del Mac,
son la memoria asignada a la máquina virtual. Aunque te resignes a ir por
CPU, tu techo de memoria no es el del equipo, es el de la VM.
La vía correcta en Apple Silicon: nativo
En un Mac con chip de la serie M, llama.cpp se compila con soporte Metal y usa la GPU sin intermediarios. Además juega con ventaja: la memoria es unificada, así que el modelo no tiene que caber en una franja separada de memoria de vídeo, sino en la memoria del equipo. Un Mac de 32 GB sirve modelos que en una tarjeta de 16 GB no entran.
brew install llama.cpp
Y se sirve igual que en Linux, con la misma API compatible con OpenAI:
llama-server \
  -m ~/models/mi-modelo-UD-Q4_K_XL.gguf \
  --host 127.0.0.1 --port 8083 \
  -ngl 99 \
  -c 8192
Las banderas de Vulkan de este artículo (--device Vulkan0,
GGML_VULKAN_DISABLE_CPU_FALLBACK) no pintan nada aquí: son de otro backend.
-ngl 99 sí, y significa lo mismo.
Para que arranque al encender el equipo, lo propio del sistema es un launchd
con un .plist en ~/Library/LaunchAgents, no systemd ni el
restart: unless-stopped de Docker.
La formulación precisa, para quien venga a corregirte
Decir "con Docker no puedes usar la GPU en un Mac" a secas es impreciso. Lo exacto es: el contenedor no accede a Metal. Docker ofrece un ejecutor de modelos que sí usa la GPU, y lo hace precisamente ejecutando el modelo en el sistema, fuera del contenedor, exponiendo después una API compatible con OpenAI. O sea, no contradice nada de lo anterior: lo confirma. La GPU se usa desde fuera, nunca desde dentro.
Entonces, ¿Docker en Mac nunca?
Sí, en dos casos:
- Para el resto de piezas. Base de datos vectorial, base de datos de siempre, proxy: todo eso en contenedor va perfecto, porque no necesita GPU. Lo único que se queda fuera es el motor de inferencia.
- Para reproducir el entorno del servidor, aceptando que irá lento. Sirve para validar la configuración antes de llevarla a la máquina de verdad, no para dar servicio.
La regla, resumida: en Linux la GPU entra en el contenedor; en un Mac, no.
Lo que esto no cubre
Sé honesto con lo que has montado:
- No es alta disponibilidad. Es una máquina. Si se apaga, no hay servicio.
- No hay autenticación. El servidor de llama.cpp escucha sin credenciales; ponerlo accesible desde internet sin nada delante es regalar la tarjeta.
- La imagen
:server-vulkanse mueve. Fija una versión concreta antes de que esto sea importante para alguien. - Un modelo local no gana a los grandes comerciales en las tareas más difíciles. Para clasificar, resumir, buscar en documentos propios y responder consultas internas, sobra.
Con eso claro, lo que queda es un servicio de inferencia propio, en hardware que ya tenías, que habla el mismo idioma que la API que ibas a pagar.