
Una sola GPU son turnos: repartir la tarjeta entre chat, imagen y vídeo
Una sola GPU son turnos: repartir la tarjeta entre chat, imagen y vídeo
Segunda parte de Servir un modelo de IA en una GPU AMD con Docker, sin ROCm. Allí quedó levantado el servicio de chat. Aquí entra todo lo demás a pelearse por la misma tarjeta.
En el artículo anterior el objetivo era modesto: que un modelo de lenguaje respondiera desde una GPU AMD, dentro de Docker, y siguiera vivo tres días después. Al final había una sección corta —"qué hacer cuando la tarjeta hace falta para otra cosa"— que despachaba en cuatro párrafos un problema que en realidad da para un artículo entero.
Este es ese artículo.
El planteamiento es sencillo de enunciar: una tarjeta, tres cargas de trabajo que la quieren, y ninguna forma de que quepan a la vez. Lo que sigue es cómo se reparte sin que nada se quede colgado y sin que un fallo a mitad deje el servicio principal caído.
Todo está sacado del mismo servidor real del artículo anterior: una Radeon RX 9070 XT de 16 GB sobre AlmaLinux, sin entorno gráfico.
La restricción, en números
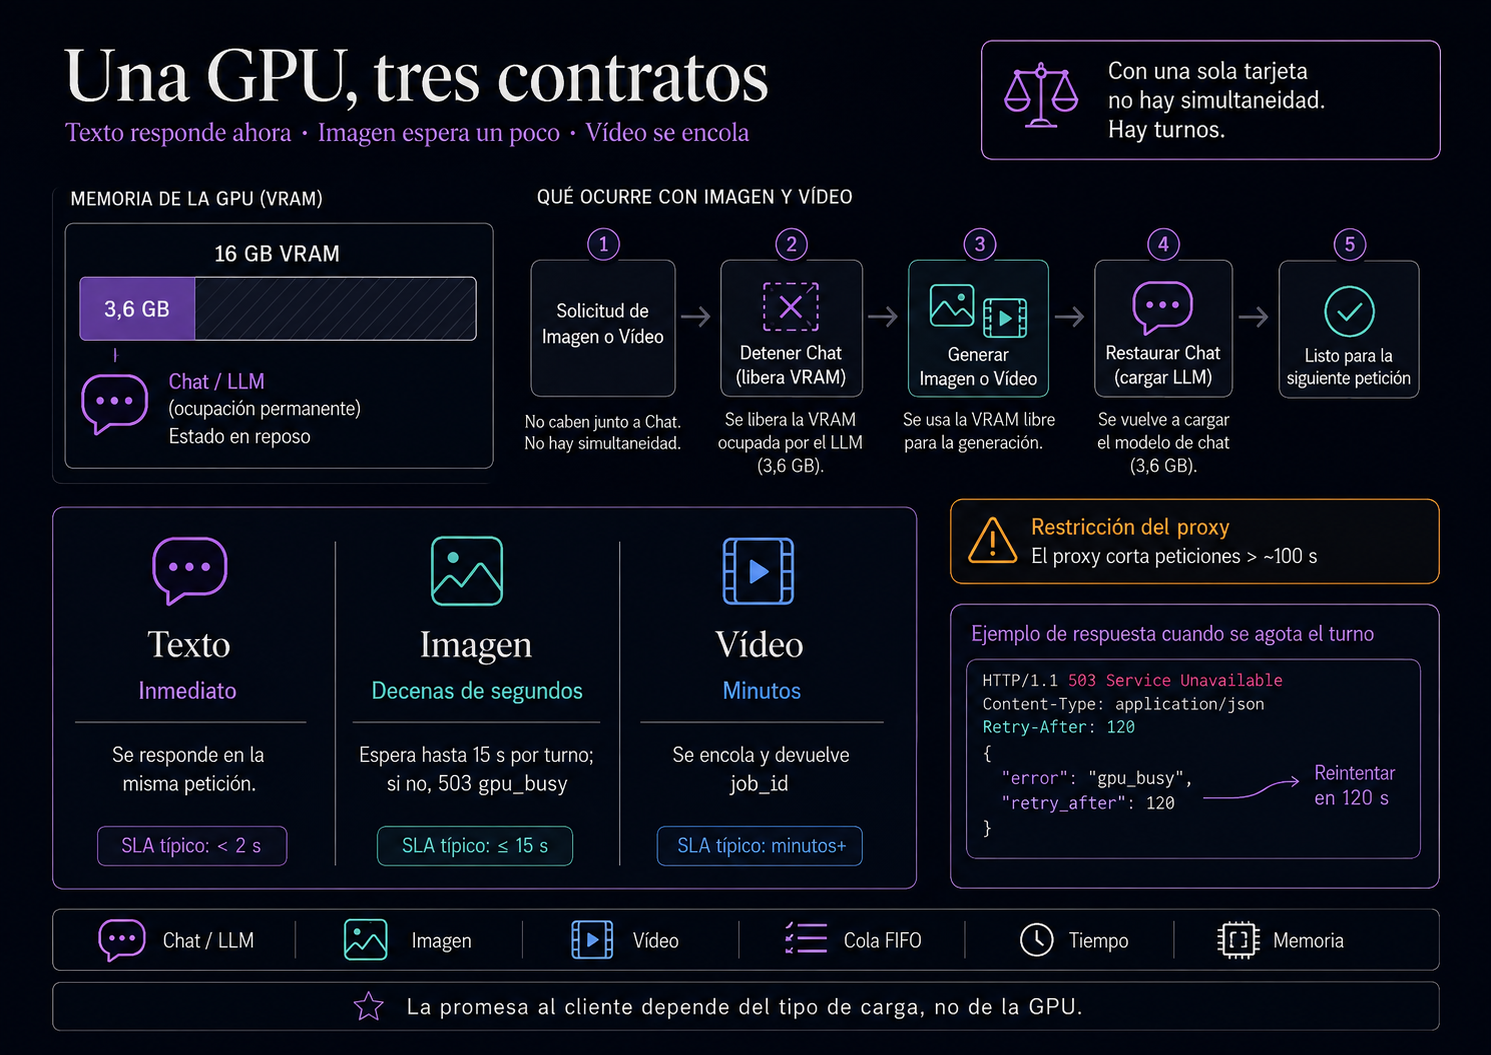
El modelo de chat está cargado de forma permanente y ocupa unos 3,6 GB de los 16 de la tarjeta. Ese es el estado de reposo del sistema: siempre hay algo dentro de la GPU.
Los modelos de difusión —los que generan imagen y vídeo— no caben al lado. No es que vayan lentos: es que no entran. Así que generar una imagen no es "una petición más", es parar el chat, liberar la memoria, generar, y devolver el chat a su sitio.
De ahí sale la única frase que hay que interiorizar antes de diseñar nada:
Con una sola tarjeta no hay peticiones simultáneas. Hay turnos.
Y si hay turnos, hace falta decidir quién los reparte, cuánto se espera y qué se le contesta a quien no le toca.
Tres cargas, tres contratos distintos
El error de diseño más caro aquí es tratar las tres igual. No lo son, y cada una merece una promesa distinta al que llama:
| Carga | Cuánto tarda | Qué se promete |
|---|---|---|
| Texto | Inmediato | Se responde en la misma petición |
| Imagen | Decenas de segundos | Se espera un poco; si no toca turno, |
| se dice que no | ||
| Vídeo | Minutos | No se responde: se encola y se devuelve un identificador |
Hay un condicionante externo que fija estos límites y conviene tenerlo delante desde el principio: el proxy de entrada corta las peticiones que pasan de unos 100 segundos. Cualquier diseño que confíe en "el cliente esperará lo que haga falta" está roto antes de escribirse. El vídeo no puede ser síncrono aunque quisiéramos.
La regla de los quince segundos
Cuando llega una imagen y la GPU está ocupada, hay dos opciones malas y una buena.
Las malas: esperar indefinidamente —el cliente se come el corte del proxy y ve un error genérico que no explica nada— o rechazar al instante, que convierte cualquier solapamiento momentáneo en un fallo.
La buena es esperar un rato corto y, si no hay turno, contestar la verdad:
# El lock lo suelta un vídeo en minutos, no en segundos: si no llega
# en IMAGE_LOCK_WAIT_S, mejor un gpu_busy honesto que un timeout.
if not GPU.acquire(timeout=config.IMAGE_LOCK_WAIT_S):
    raise TimeoutError
Quince segundos de espera, y si no, 503 con un cuerpo que dice qué pasa y una
cabecera Retry-After: 120 que dice cuándo volver:
return error(503, "gpu_busy", "a video job holds the GPU", retry_after=120)
Esa cabecera es la diferencia entre un error y una instrucción. Un cliente bien
escrito la lee y reintenta solo; uno mal escrito, al menos, falla rápido en vez
de quedarse colgado. Un 500 genérico no le habría dado ninguna de las dos
cosas.
Dos niveles de exclusión, y por qué hacen falta los dos
Aquí está la parte que cuesta ver hasta que te muerde.
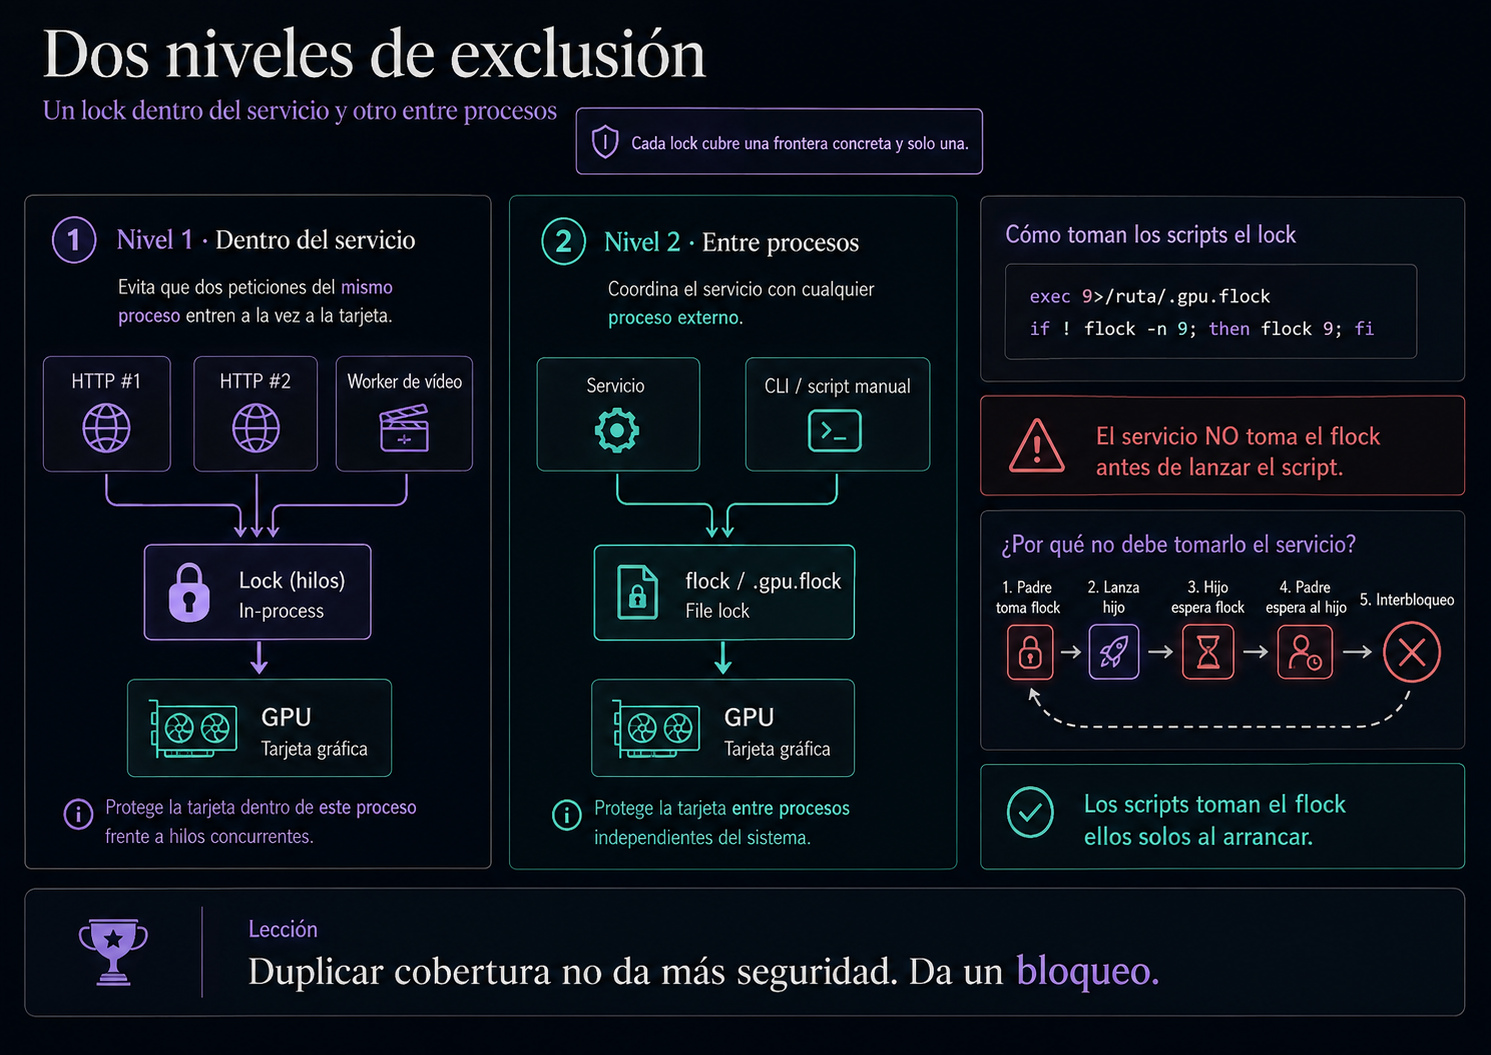
Nivel 1: dentro del servicio. Un Lock normal de hilos basta para que dos
peticiones HTTP simultáneas, o una petición y el worker de vídeo, no entren a la
vez a la tarjeta.
Nivel 2: entre procesos. Los scripts de generación se pueden lanzar también
a mano desde la línea de comandos, y ese uso no pasa por el servicio. Un lock de
hilos no lo ve. Para eso está un flock sobre un fichero:
# Exclusion ENTRE PROCESOS: sin esto, dos generaciones a la vez se pisan la
# VRAM y, peor, la segunda ve el chat ya parado, no arma _CHAT_ESTABA_ARRIBA
# y cuando la primera termina rearranca el chat en mitad de la segunda.
exec 9>/ruta/.gpu.flock
if ! flock -n 9; then
    echo "[gpu] esperando a que termine otra generacion..."
    flock 9
fi
Fíjate en el "y peor" del comentario. El daño obvio de dos generaciones a la vez es que se pisan la memoria. El daño no obvio es que la contabilidad del estado se corrompe: la segunda generación encuentra el chat ya parado, deduce que no tiene que devolverlo, y la primera lo rearranca en mitad del trabajo de la segunda. Dos procesos correctos por separado producen un estado que ninguno de los dos contempló.
Y ahora la decisión que parece un descuido y no lo es: el servicio
deliberadamente NO toma el flock.
"""Serialización de la GPU DENTRO de este proceso.

Deliberadamente NO usa el flock de lib-gpu.sh: los scripts lo toman ellos
mismos al arrancar, y si este proceso lo tomara antes de lanzarlos se
bloquearía contra su propio hijo.
"""
Los scripts toman el lock ellos solos. Si el servicio lo cogiera antes de lanzarlos, se quedaría esperando a un lock que tiene él mismo, esperando a un hijo que espera al padre. Interbloqueo perfecto, y con el aspecto de "se ha quedado pillado, reinicia".
La regla general: cada lock cubre una frontera concreta y solo una. El de hilos cubre la concurrencia dentro del servicio; el de fichero cubre la concurrencia con cualquier cosa de fuera. Duplicar la cobertura no da más seguridad, da un bloqueo.
Que el chat vuelva siempre, también cuando todo sale mal
Esta es la parte que en el artículo anterior se resumía en un párrafo y que en la práctica es la que más veces te salva.
Parar el chat es fácil. Devolverlo cuando el trabajo termina bien, también.
El problema es cuando no termina bien: un fallo de memoria, un Ctrl-C, un
proceso que se muere a la mitad. Si la restauración es el último paso del guion,
ese último paso no se ejecuta nunca y el chat se queda caído hasta que alguien
escribe y no le contestan.
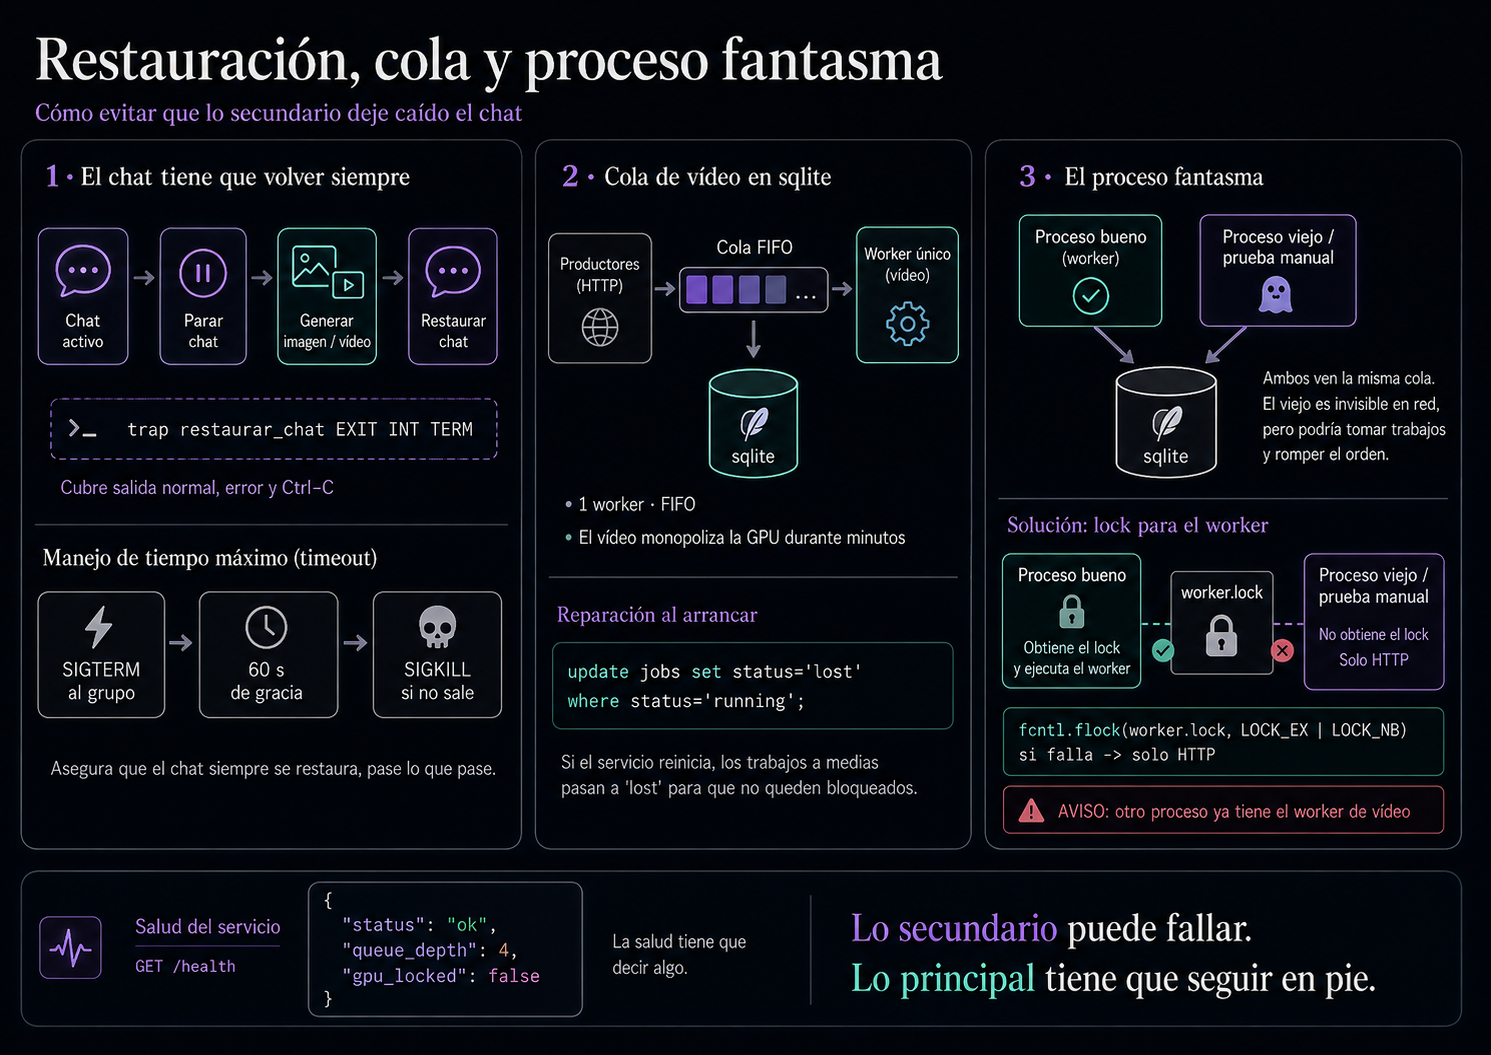
La solución es no ponerla como último paso, sino engancharla a la salida del proceso:
# El trap cubre salida normal, error y Ctrl-C.
trap restaurar_chat EXIT INT TERM
Y la restauración no se da por buena porque el comando de arranque devuelva
cero: espera a que el contenedor pase a healthy, con un tope, y avisa si no
llega.
Hay un segundo detalle, más fino, que solo aparece cuando el servicio tiene que
matar una generación por tiempo excedido. Si mandas un SIGKILL al bash, el
trap no llega a ejecutarse: el chat se queda parado y el generador se queda
huérfano ocupando la tarjeta. Lo correcto es lanzarlo en su propia sesión y
mandar la señal al grupo de procesos, dando margen para que el trap
trabaje:
# Grupo de proceso propio: en timeout se manda SIGTERM AL GRUPO, no
# SIGKILL al bash. El trap TERM de lib-gpu.sh corre y devuelve el chat;
# un SIGKILL directo dejaría el chat parado y sd-cli huérfano en la GPU.
proc = subprocess.Popen(..., start_new_session=True)
...
os.killpg(proc.pid, signal.SIGTERM)
try:
    proc.communicate(timeout=60)  # gracia para el trap
except subprocess.TimeoutExpired:
    os.killpg(proc.pid, signal.SIGKILL)
Primero se pide por las buenas, se conceden sesenta segundos, y solo entonces se mata sin contemplaciones. Matar bien es tan importante como arrancar bien.
La cola de vídeo: sqlite y un solo worker
El vídeo ocupa la tarjeta durante minutos, así que no hay nada que paralelizar. Un worker, FIFO, y el estado en sqlite:
"""Cola de trabajos de vídeo, persistida en sqlite.

Un único worker (hilo) procesa en FIFO: el vídeo monopoliza la GPU durante
minutos, así que paralelizar no tiene sentido.
"""
La pregunta interesante no es cómo se encola, es qué pasa con lo que estaba a medias cuando el servicio se reinicia. Los trabajos en cola se retoman solos, eso es gratis. Pero un trabajo que estaba ejecutándose tiene su proceso muerto y su registro diciendo "ejecutando". Si no se hace nada, se queda así para siempre y quien pregunte recibirá "en curso" hasta el fin de los tiempos.
Así que al arrancar, lo primero es cerrar esa mentira:
update jobs
   set status = 'lost',
       error = 'media-api restarted during generation',
       finished_at = ?
 where status = 'running'
lost no es error. Es un estado propio que dice exactamente lo que pasó: esto
no falló, se perdió porque reiniciamos. Quien consulte sabe que puede reintentar
y por qué. Un sistema honesto sobre sus propios reinicios ahorra más tiempo de
soporte que uno que finge que no ocurren.
El proceso fantasma
Este apartado existe porque pasó de verdad, y es el tipo de fallo que no se deduce leyendo el código: se deduce viendo un resultado imposible.
Un día, un vídeo salió generado con código antiguo. El servicio estaba actualizado, se había reiniciado limpiamente, y aun así el resultado correspondía a una versión anterior.
La causa: un proceso del servicio lanzado a mano tiempo atrás para una prueba había sobrevivido al reinicio del servicio. No tenía el puerto —lo tenía el proceso bueno— así que era invisible por completo: no aparecía escuchando en ningún sitio, nadie lo miraba. Pero compartía la base de datos de la cola, y su worker seguía reclamando trabajos. Le robó uno al proceso bueno y lo generó con el código de aquel día.
El arreglo es que el worker no arranca por defecto: arranca solo el proceso que consigue un lock de fichero.
_worker_lock = open(config.DATA / "worker.lock", "w")
try:
    fcntl.flock(_worker_lock, fcntl.LOCK_EX | fcntl.LOCK_NB)
except OSError:
    print("AVISO: otro proceso ya tiene el worker de vídeo; "
          "esta instancia solo atenderá peticiones HTTP", flush=True)
    return False
Tres cosas de este fragmento merecen atención:
LOCK_NB: no espera. Si otro lo tiene, esta instancia sigue viva atendiendo HTTP, solo que sin worker. Degradar es mejor que morir.- El aviso se imprime. El escenario "hay un proceso de más" deja rastro en el registro en vez de ser silencioso.
- El fichero se mantiene abierto mientras viva el proceso. Cerrarlo soltaría el lock. Y como el sistema operativo lo libera al morir el proceso, no hay estado que limpiar: no existe el caso "el lock se quedó puesto tras un corte de luz", que es la ruina de los locks implementados a mano en base de datos.
La lección general, más allá de este servicio: si tu proceso puede correr dos
veces, algún día correrá dos veces. Un systemctl restart no garantiza que no
haya quedado nada por ahí; solo garantiza lo que hay bajo su control.
La salud tiene que decir algo
El último detalle es pequeño y cambia mucho el día de un incidente. El endpoint
de salud no devuelve ok a secas:
return {
    "status": "ok",
    "queue_depth": jobs.queue_depth(),
    "gpu_locked": gpu_locked(),
}
Con esos dos números, "va lento" deja de ser una opinión. O hay cuatro trabajos en cola y el sistema está haciendo exactamente lo que debe, o la cola está vacía y la GPU bloqueada, y entonces hay algo agarrado que no debería. Son dos diagnósticos opuestos que desde fuera se ven idénticos.
Lo que esto no cubre
Igual que en la primera parte, conviene ser explícito con los límites:
- No es un planificador. No hay prioridades ni cuotas por usuario: quien pide primero, va primero. Con más de un consumidor real, eso hay que revisarlo.
- Sigue siendo una máquina. Todo esto reparte una tarjeta; no la duplica.
- La cola no tiene caducidad. Un trabajo perdido se queda en la base hasta que alguien la limpie.
Lo que sí cubre es el escenario que de verdad ocurre a diario: varias cargas compitiendo por un recurso que no se puede compartir, sin que la principal se caiga por culpa de las otras.
Y esa es la idea que se lleva uno de aquí, que no es de GPUs:
Lo secundario puede fallar. Lo principal tiene que seguir en pie —y volver solo cuando lo secundario falla.