
Del 27B al 4B: elegir un modelo por el servicio, no por el ranking
Del modelo de 27B al de 4B: elegir un modelo por el servicio, no por el ranking
Tercera entrega de la serie del servidor de IA local. En la primera levantamos un modelo de lenguaje en una GPU AMD con Docker. En la segunda repartimos la tarjeta entre chat, imagen y vídeo. Esta va de una decisión que tomé al revés.
El servidor es el mismo de siempre: una Radeon RX 9070 XT de 16 GB sobre AlmaLinux, sin entorno gráfico. El servicio de chat corre con llama.cpp sobre Vulkan.
A mediados de septiembre ese chat lo servía un modelo de 27.000 millones de parámetros. A finales de mes lo cambié por uno de 4.000 millones. El servicio mejoró. Este artículo cuenta por qué, y qué medí antes de dar por buena la decisión.
El punto de partida: un modelo grande para un solo usuario
El 13 de septiembre puse en el chat un modelo de 27B cuantizado a 2 bits, con 262.144 tokens de contexto y una sola ranura de conversación (--parallel 1).
Para que cupiera hubo que apretar. Con la caché de atención (KV) en f16 o en q8_0, una parte se salía de la VRAM a la memoria del sistema y la velocidad caía a unos 8 tokens por segundo. Con la caché en q4_0 y decodificación especulativa con un modelo borrador, llegó a unos 62 tokens por segundo. La tarjeta quedaba a ~15,9 GB y aun así se iban otros ~2,5 GB a memoria del sistema.
Funcionaba. Para un usuario.
La pregunta que no me había hecho
Unos días después hice la pregunta que tendría que haber hecho primero: ¿para qué es este chat?
La respuesta era bastante concreta. Iba a ser un agente que concierta citas por mensaje. Alguien escribe "¿tienes hueco el jueves por la tarde?", el agente consulta la agenda y reserva. No tiene que escribir ensayos ni razonar sobre código. Tiene que atender a varias personas a la vez sin hacerlas esperar.
Con ese uso delante, hice las cuentas para cinco o seis conversaciones en paralelo con el modelo grande:
- 5 ranuras × 262k tokens (1,31 millones de tokens, ~27 GiB de caché): no cabe.
- 6 ranuras × 131k tokens (786k tokens, ~16,5 GiB de caché): tampoco.
- Repartiendo la caché sin salirse de la VRAM quedaban unos 140k tokens en total. Con 6 ranuras, unos 23k por conversación.
Y miré los registros de uso real de dos semanas: 10 peticiones, mediana de unos 22k tokens, máximo 64k.
El modelo grande no podía atender a varias personas a la vez y, además, la ventana de 262k que tanto había costado meter no la estaba usando nadie.
El cambio
El 29 de septiembre el chat pasó a Gemma 4 E4B, cuantizado a Q4_1, con su modelo borrador para la decodificación especulativa:
--parallel 8: ocho conversaciones simultáneas.-c 524288: 64k tokens por conversación, que cubre el máximo que vimos en los registros.- Caché KV en f16, sin cuantizar.
Resultado medido después del cambio:
| 27B (antes) | E4B (después) | |
|---|---|---|
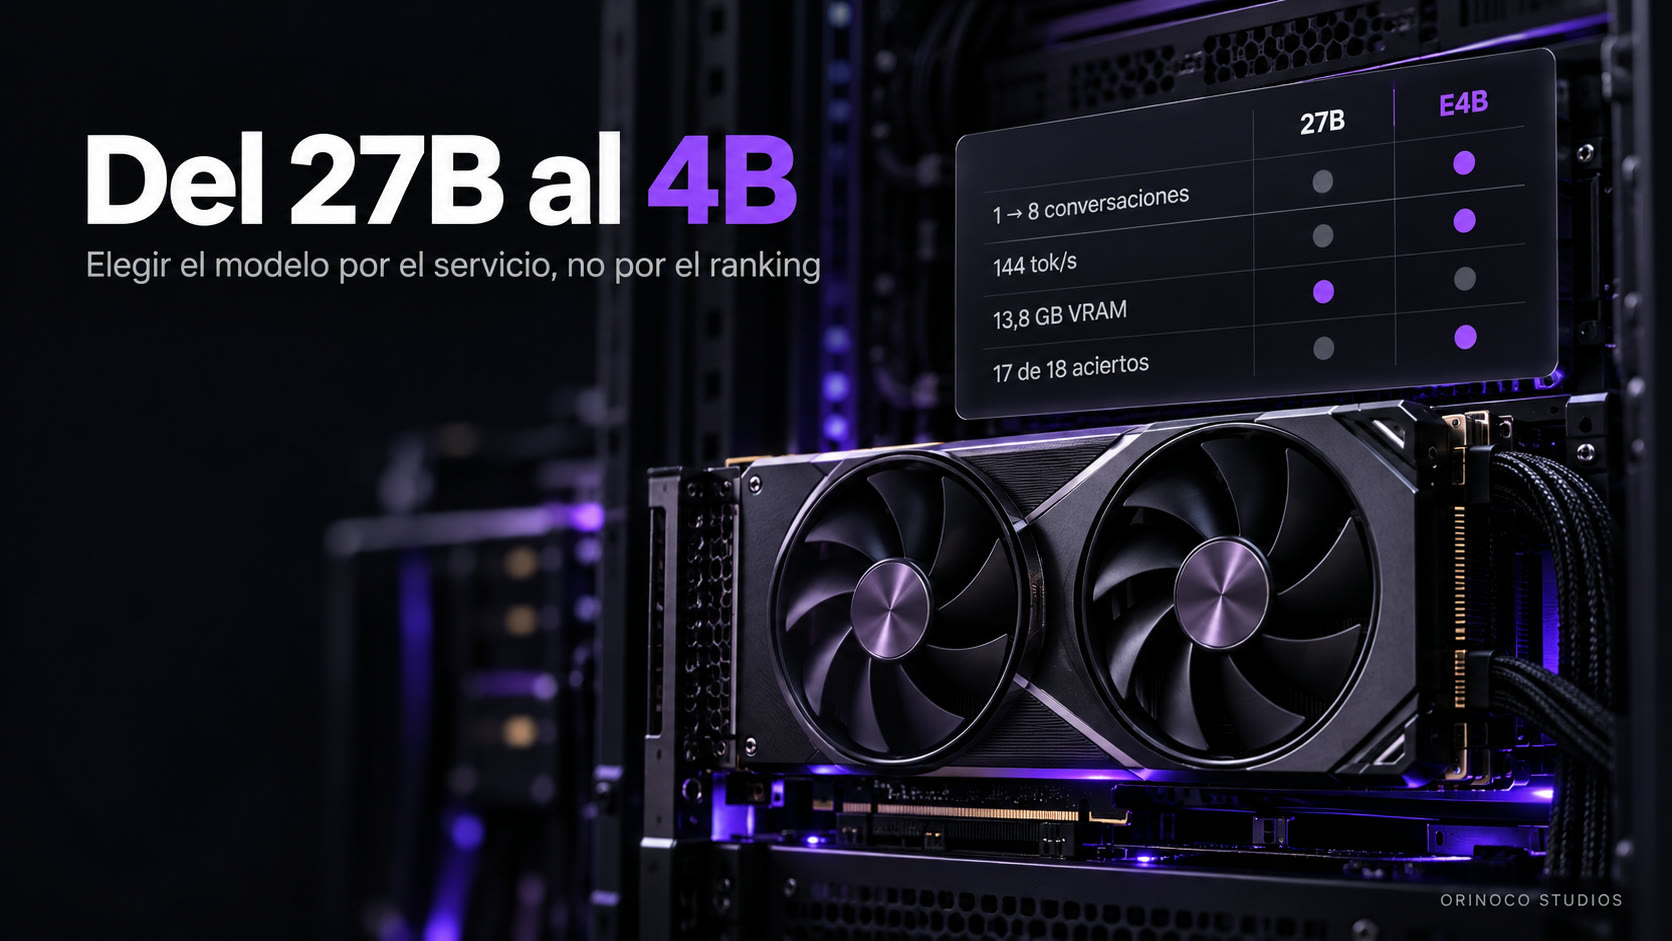
| Conversaciones simultáneas | 1 | 8 |
| Contexto por conversación | 262k | 64k |
| VRAM | ~15,9 GB + ~2,5 GB fuera | 13,8 GB + 0,24 GB fuera |
| Velocidad, 1 petición | ~62 tok/s | 144 tok/s |
| Velocidad, 8 a la vez | — | 400 tok/s en total (~53 por conversación) |
El modelo grande lo guardé un tiempo en disco por si cambiaba el uso. No cambió, y acabé borrándolo.
El interruptor de razonamiento
El modelo nuevo trae el razonamiento activado por defecto: piensa antes de responder. En la primera prueba, de 400 tokens de salida casi todos eran razonamiento. Con enable_thinking=false la respuesta directa ocupaba 131.
Mi primera recomendación fue apagarlo. Más rápido y más barato para un agente que solo reserva citas.
Antes de dejarlo así, lo medí. Monté un banco de pruebas con el agente real y sus dos herramientas (check_availability y book_appointment): 6 casos de reserva, 3 repeticiones de cada uno y temperatura 0,2.
| Razonamiento ON | Razonamiento OFF | |
|---|---|---|
| Aciertos | 17-18 de 18 | 9 de 18 |
| Tokens de salida | ~200 | ~20 |
| Latencia mediana | ~0,8 s (máx. 1,6 s) | ~0,16 s |
La diferencia es grande, pero lo interesante es en qué fallaba la versión rápida.
Nunca reservó una fecha equivocada. Lo que hacía era negarse a resolver fechas relativas ("este jueves", "mañana", "el sábado") y pedirle al usuario la fecha exacta. Es un fallo prudente. Pero una persona que escribe "el sábado" no quiere que le pregunten qué sábado.
Probé a arreglarlo sin activar el razonamiento: metí en el prompt de sistema un calendario precalculado de los 14 días siguientes. No cambió nada. El modelo seguía pidiendo la fecha.
Así que la elección no era velocidad frente a precisión. Era 0,6 segundos más por mensaje a cambio de que el agente haga el trabajo de calendario, que al final es el motivo por el que existe. En una conversación por mensajería, 0,8 segundos no los nota nadie.
Se quedó el razonamiento activado. Y la recomendación anterior, la de apagarlo, quedó anotada como superada.
Lo que me llevo
- Primero el servicio, después el modelo. Yo elegí el modelo más capaz que cabía en la tarjeta y luego busqué para qué usarlo. Al revés sale mejor.
- Mira los registros antes de dimensionar. Mi ventana de 262k servía para un caso de uso que no existía. El uso real cabía en 64k.
- Concurrencia antes que tamaño. Para un agente que atiende a varias personas, ocho conversaciones de un modelo pequeño valen más que una de uno grande.
- Mide la opción "obvia" antes de aplicarla. Apagar el razonamiento parecía lo sensato y habría dejado el agente a la mitad de aciertos.
- Mira cómo falla, no solo cuánto. 9 de 18 suena mal. Que esos 9 fallos fueran preguntas prudentes y no reservas equivocadas cambia mucho el riesgo.
Lo que esto no cubre
- No es un benchmark general. Son 6 casos de un agente concreto. Sirve para decidir este servicio, no para opinar sobre el modelo.
- No compara modelos pequeños entre sí. Cambié de 27B a E4B porque era la decisión de capacidad. No probé otros de tamaño parecido.
- Una sola tarjeta sigue siendo una sola tarjeta. Las reglas de turnos de la segunda entrega siguen valiendo cuando entran la imagen o el vídeo.